同济大学城乡规划学硕士在读。曾在爱奇艺智能平台部任 AI 中台产品实习生,负责「短剧出海重制智能体」从 0 到 1 的产品定义与验证。
作品集收录 AI 内容生产、专业研究与个人效率三个方向的四个项目,展示需求分析、流程与交互设计、前端原型及效果验证。
中文短剧批量重制为海外版本的 B 端工具。负责产品定义与交互设计,支持业务方完成整剧制作与上线;单集人工操作及修改约由 60 分钟降至 20—30 分钟。
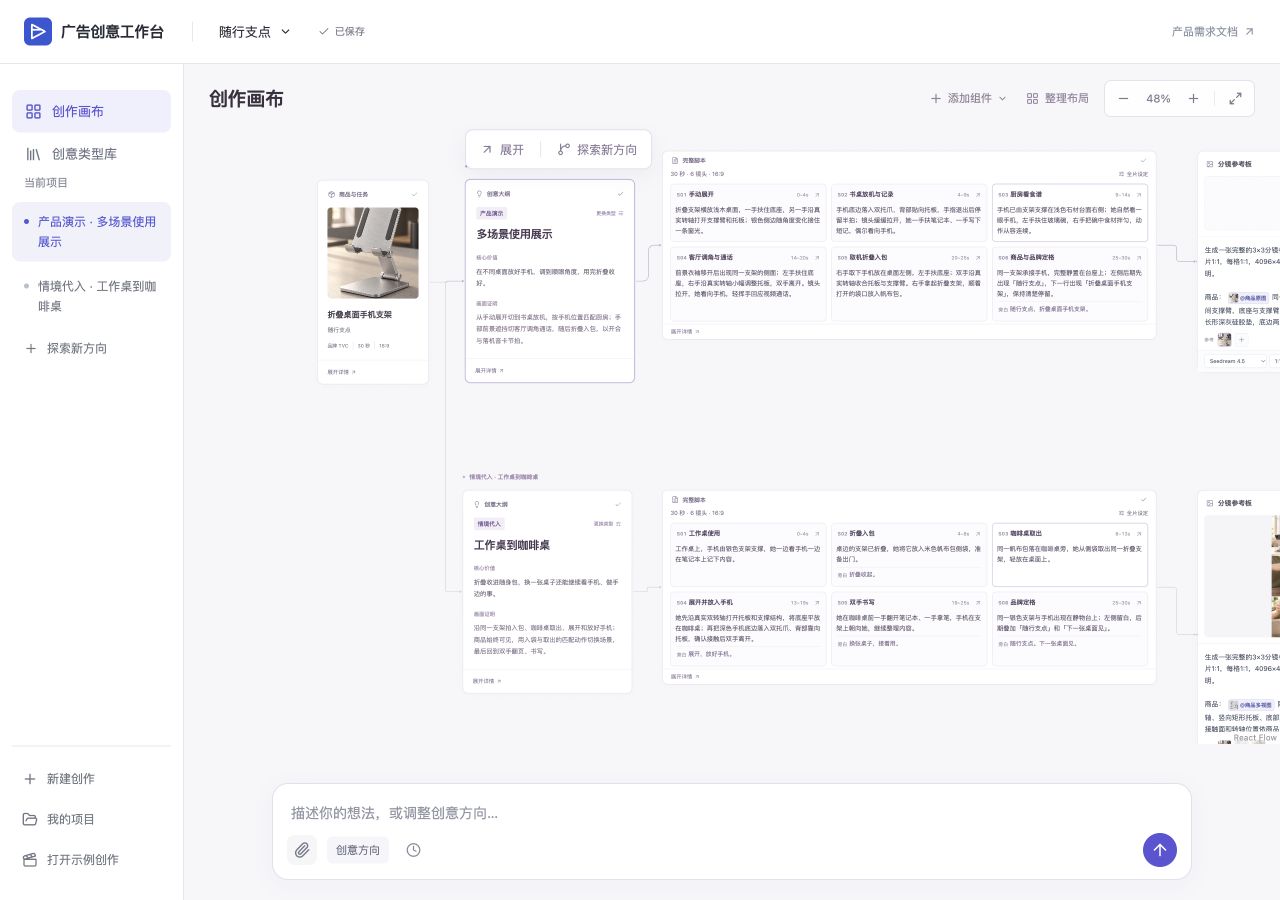
将专业广告工作流与可编辑画布结合,由统一 Agent 组织任务。在同一商品项目中完成创意构思、过程预览、精细调整与分支探索,逐步生成广告视频。
数据集构建、模型输出检视、专家评价三个独立工具,支撑了 13 位专家规模的人机对照测评实验。
将投递、探查、准备与复盘集中管理,并辅助网页填报。由本人定义需求和协作流程,已在个人求职中管理六千余条招聘记录、百余份探查报告,项目已开源。
作品预览选择项目查看界面
中文短剧批量重制为海外版本的 B 端工具。负责产品定义与交互设计,支持业务方完成整剧制作与上线;单集人工操作及修改约由 60 分钟降至 20—30 分钟。
阅读项目面向短剧制作团队的 B 端生产工具,将中文剧集转化为海外版本。覆盖剧集解析、改编方向、资产与剧集改编、视频生成,生成素材经人工后期处理后形成整剧。
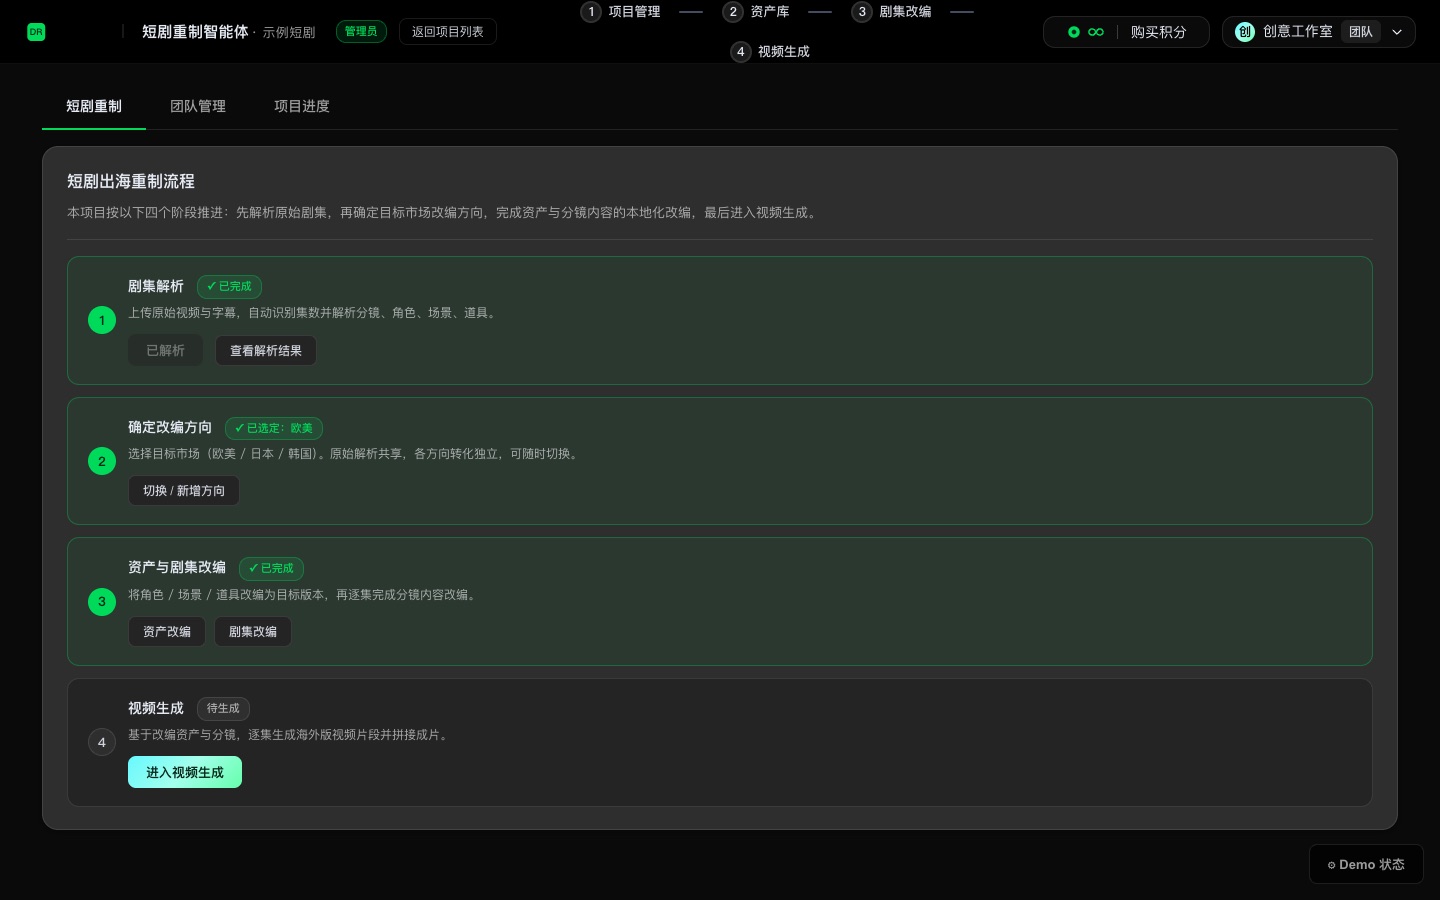
中文短剧进入海外市场,需要翻译台词、改编人物与场景、逐镜重制视频。生成工具分散,资料依赖人工传递,整剧还需保持跨镜头一致性。
将分散的生成能力组织为整剧生产流程,减少逐镜整理资料与重复操作,在保持改编质量的前提下缩短人工制作时间。
负责产品定义、功能流程、交互设计与前端原型,完成多阶段 Demo,并根据业务制作反馈迭代。
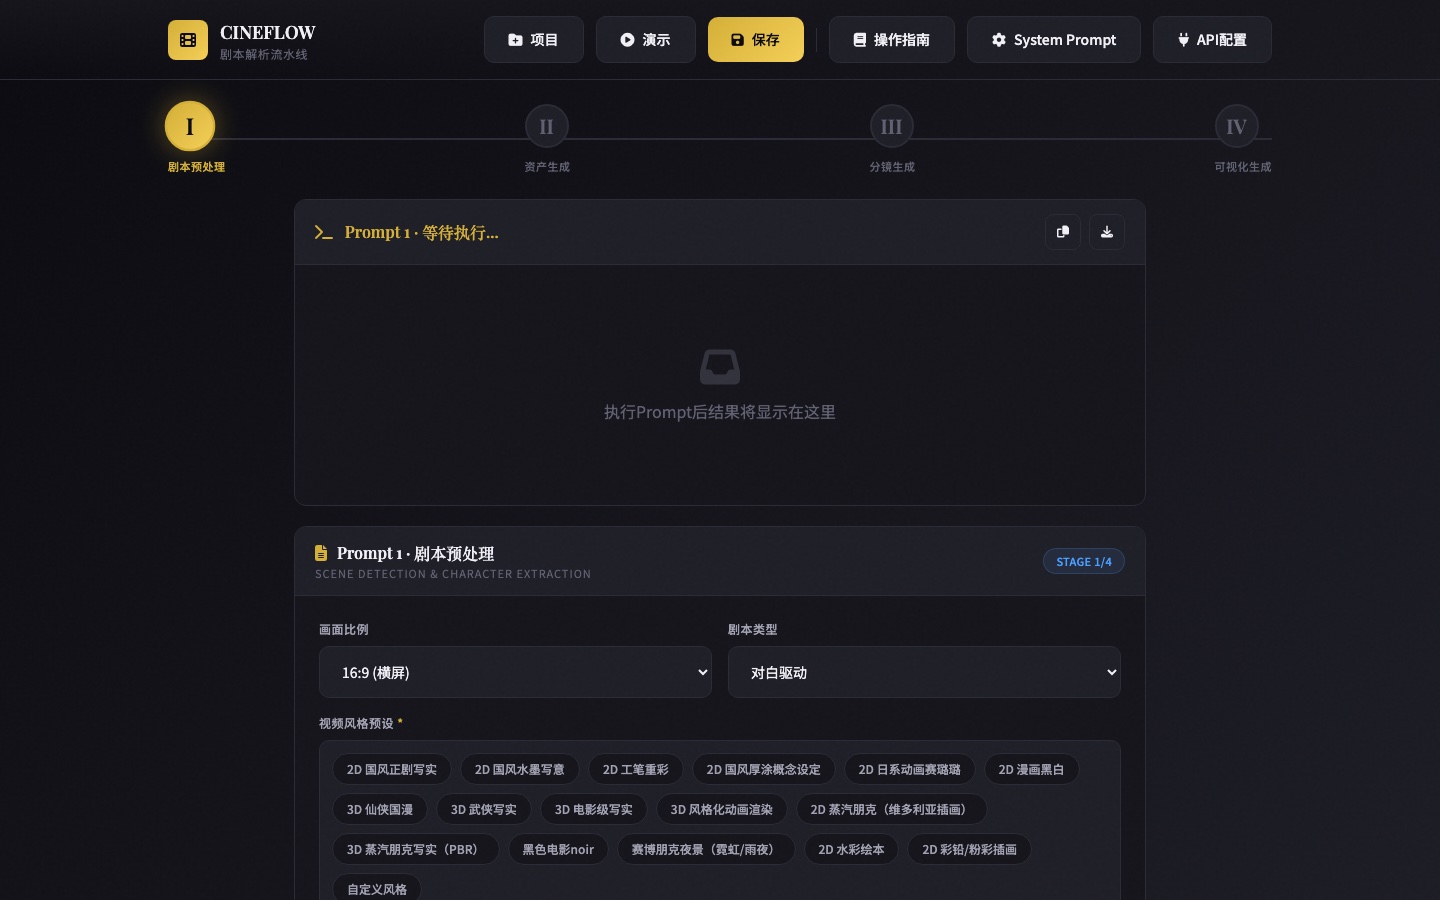
导入视频与字幕,识别集数、分镜、角色、场景和道具,形成结构化资料。
选择目标市场。各版本沿用同一份剧集解析,分别保存改编内容。
统一生成人物与场景参考,按集完成分镜本地化,并对照原文确认。
基于改编资料逐镜生成,调整提示词与参数,预览、回退并导出素材。
调研视频转化、角色替换、翻译配音、短剧创作和内容提取五类工具后,确定以整剧生产为单位组织产品:系统批量处理资料与生成任务,制作人员在改编和视频结果处进行确认。
| 关键问题 | 产品决策 | 验证重点 |
|---|---|---|
| 整剧资料重复处理 | 一次解析、统一资产;分镜引用人物与场景资料。 | 单集人工操作与修改时长 |
| 批量改编难以逐条检查 | 原文与改编结果对照,保留单集调整与重做入口。 | 改编是否满足目标市场要求 |
| 视频结果不稳定 | 逐镜预览,提示词与结果成对保留,可重试或回退。 | 达标所需生成次数、业务验收 |
资产管理与剧集改编:先统一全剧视觉资料,再将资料带入逐集分镜。制作人员可批量处理,并对照原文检查改编内容。
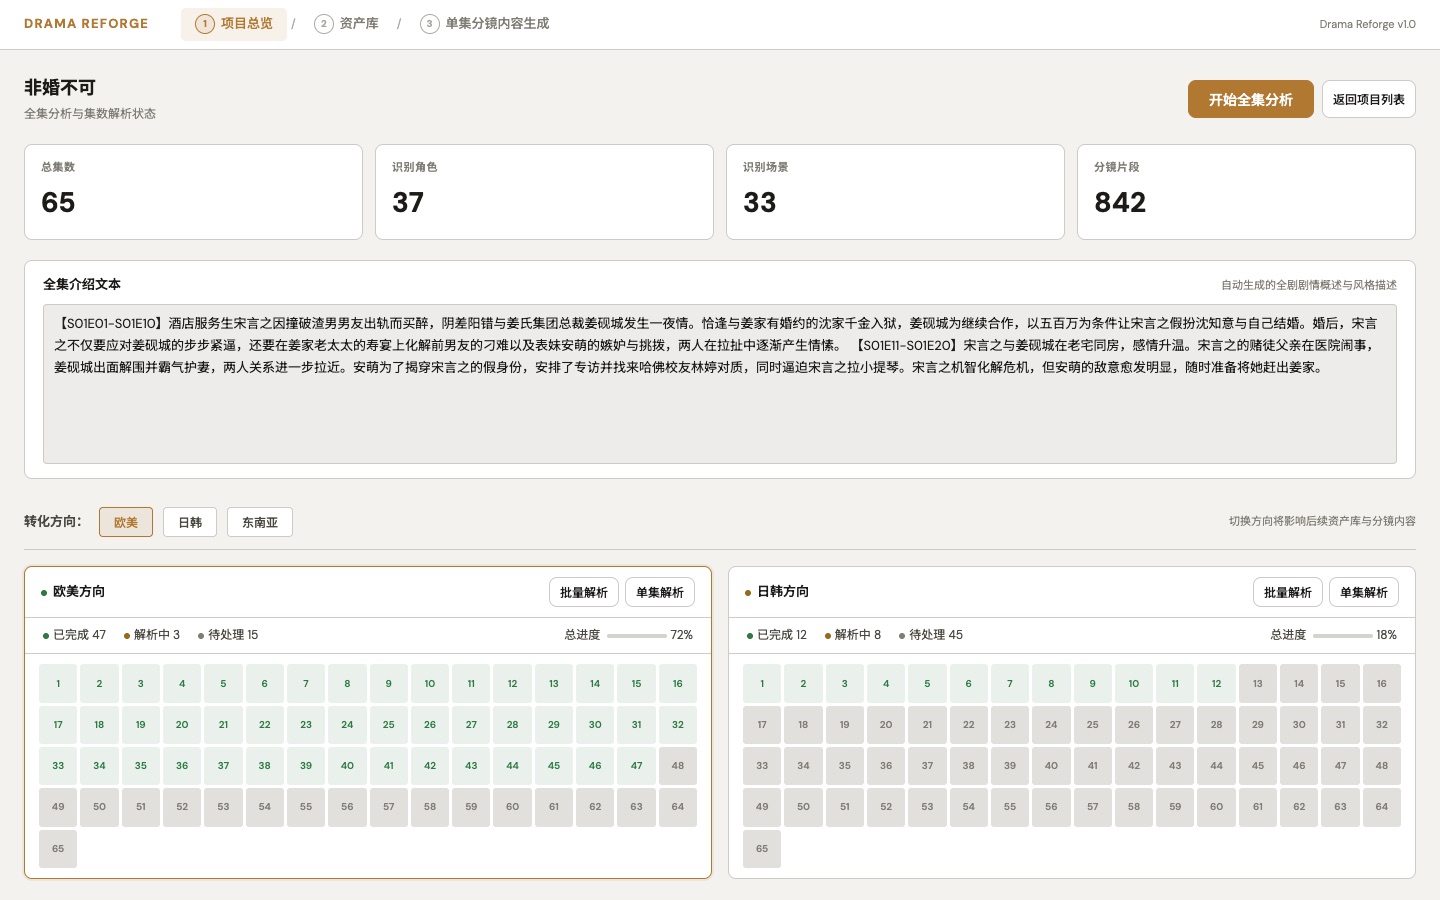
四个阶段展示完成状态与操作入口;解析进度按单集呈现。

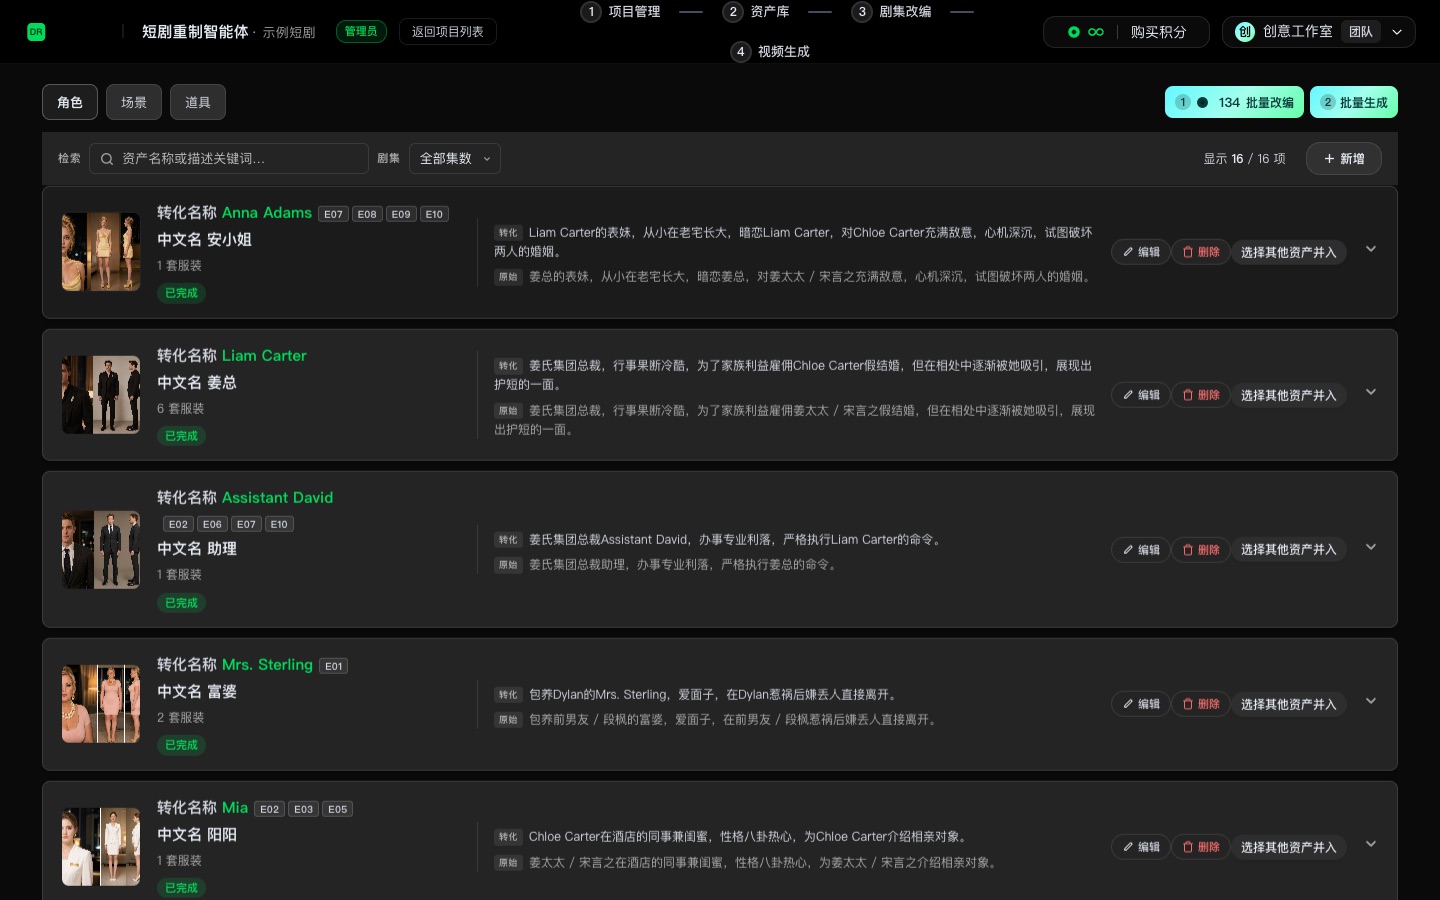
原名与译名、原始与改编描述成对呈现;支持多视图、分服装建档、批量改编与生图。
原文与译文左右对照,提示词通过 @ 引用角色与场景;支持单集附加要求和重新改编。
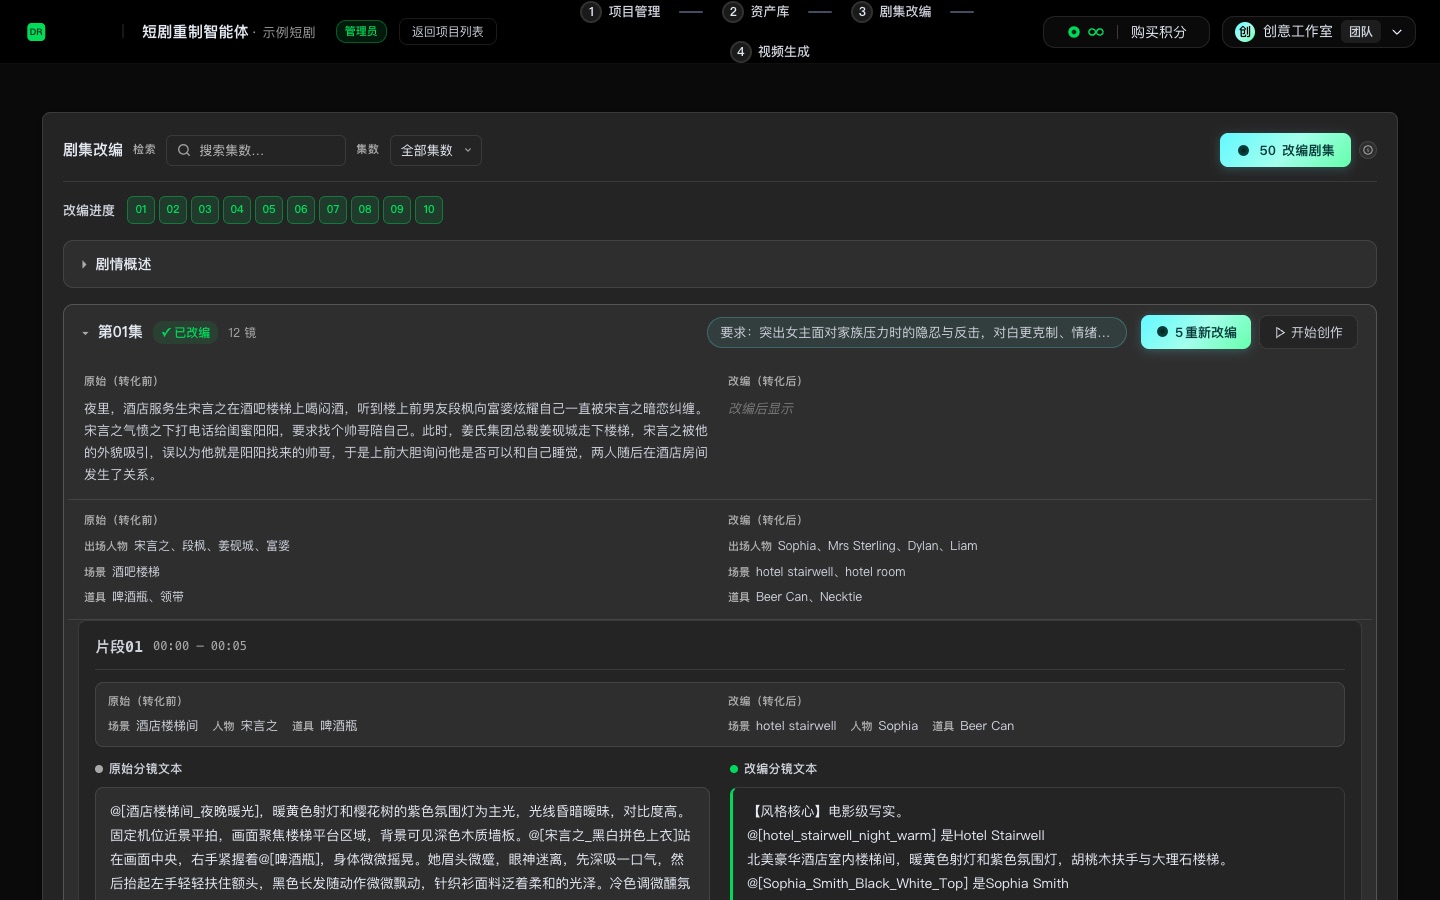
设计重点:以原始内容为对照依据,将全剧统一设定与单镜改编分开处理。资产变更时同步处理分镜引用,减少逐镜重复维护。
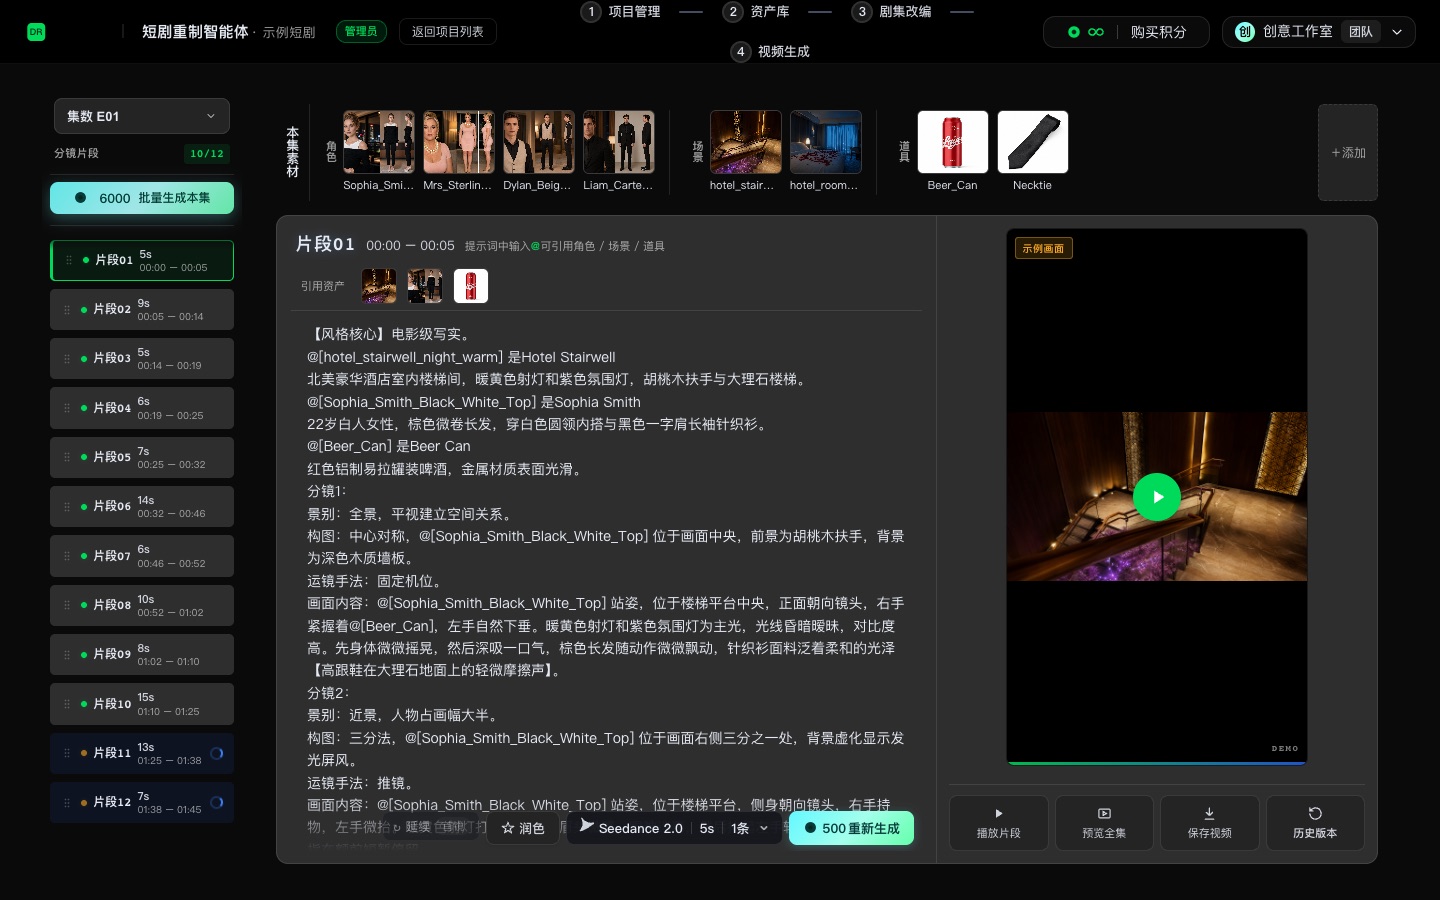
视频生产:改编确认后,制作人员进入单分镜工作室。镜头列表、生成输入和视频结果同屏呈现,支持连续处理整集镜头。
左侧选择镜头,中间编辑分镜与提示词,右侧预览结果;可通过键盘逐镜切换。

| 制作任务 | 交互设计 | 预期作用 |
|---|---|---|
| 连续制作镜头 | 镜头列表、输入与结果同屏,键盘逐镜切换;可延续上一镜。 | 减少窗口切换和重复输入 |
| 调整不满意的结果 | 提示词与视频成对保存,修改后重试,或回退到已有版本。 | 保留有效结果,控制返工范围 |
| 检查整集表现 | 在整集看板与单镜工作室间切换,按顺序拼接预览并导出。 | 检查连续性,再进入后期制作 |
先用多模型 Demo 验证生成流程,再将完整生产任务做成交互原型,交由业务方检验整剧制作的可行性。


业务方完成整剧重制并海外上线,单集人工操作与修改从约 60 分钟降至 20—30 分钟。
| 评价维度 | 实际结果 | 业务含义 |
|---|---|---|
| 人工投入 | 约 60 → 20—30 分钟 / 集 | 人工操作与修改至少减少 50% |
| 生成投入 | 约 300 元算力 / 集 | 用于评估整剧生成预算,不含人工与后期 |
| 业务交付 | 65 集英文版完成重制并海外上线 | 业务方使用 Drama Reforge 完成制作,并经人工后期与验收 |
效率对照:同一剧集的工具制作欧美版与原流程制作日本版;统计人工操作及修改时间。
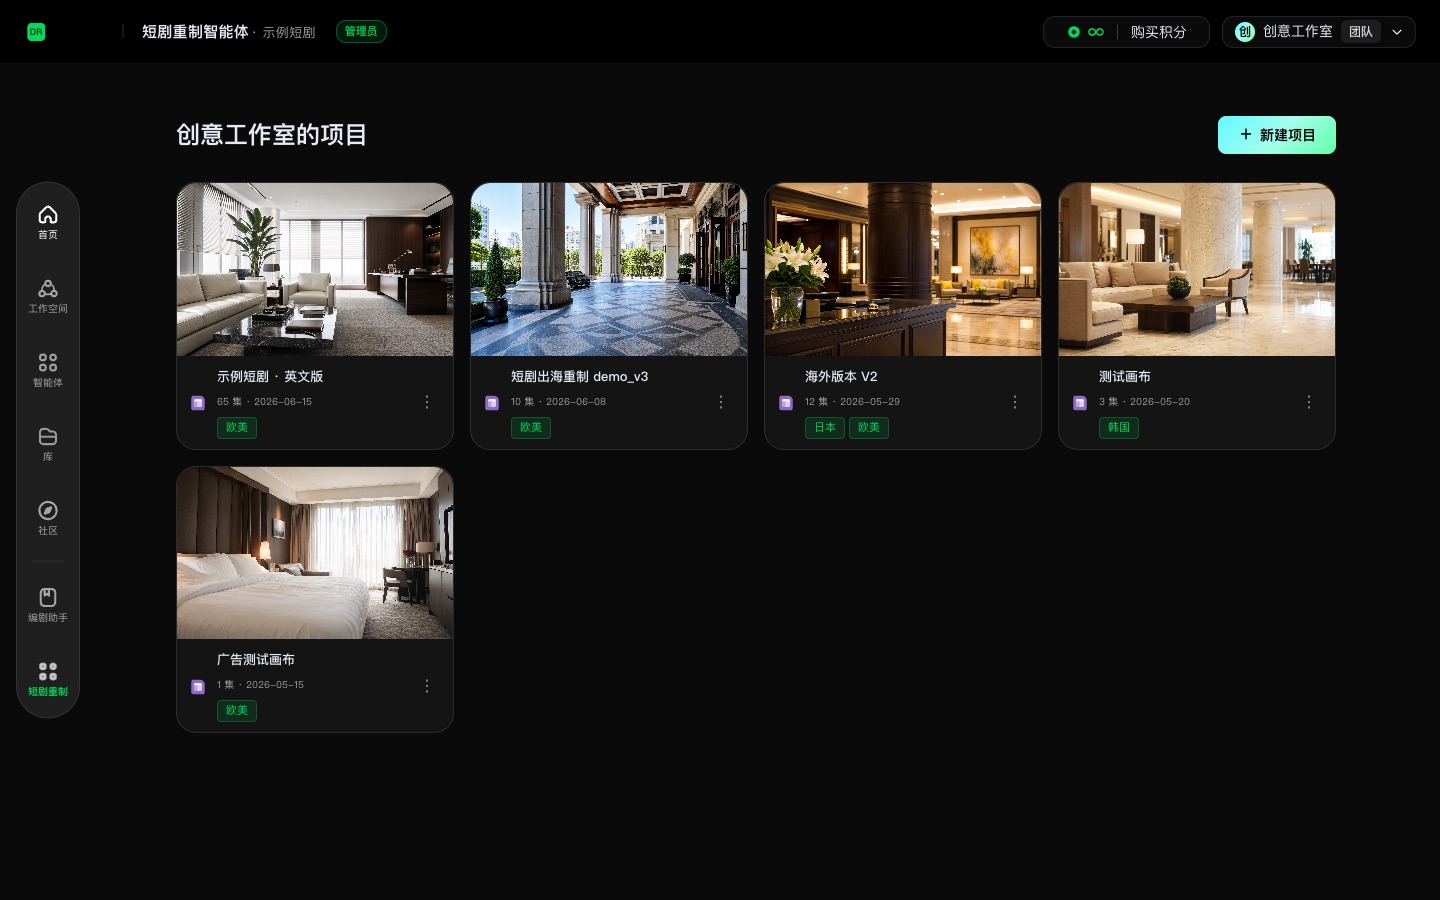
在制作反馈基础上完成 Drama Remake 平台工作台原型,将单剧生产扩展到多项目管理,集中查看目标市场、资产和解析进度,为平台集成提供交互方案。
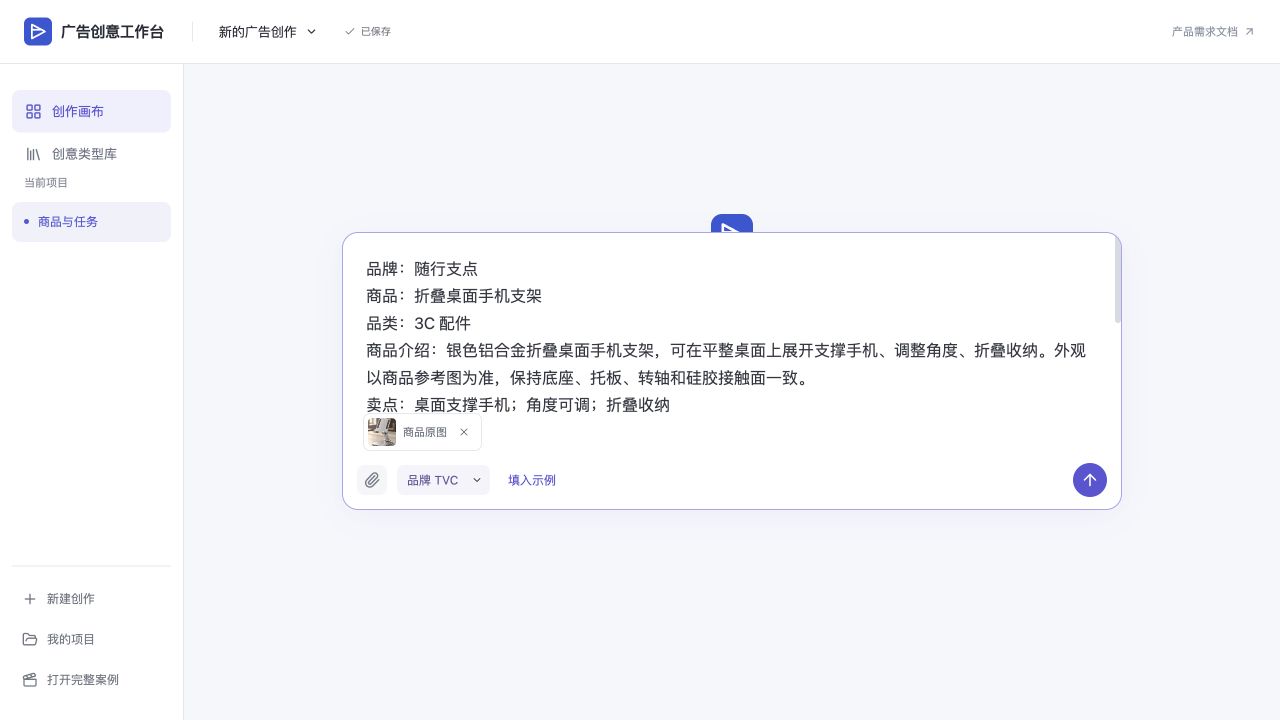
面向专业广告创作者,将广告工作流组织成可编辑、可分支的创作画布,由统一 Agent 协调任务。围绕同一商品,完成创意构思、过程预览、精细调整与多方案探索,逐步生成广告视频。

品牌内容团队和广告服务团队根据商品 Brief 制作 TVC 与投流短视频,需要比较创意、细化脚本,并持续调整画面与声音。
将专业创作方法与灵活的制作过程结合:帮助用户找到适合商品的表达,在生成视频前预览方案,并保留多个方向继续探索。
专业工作流确定制作方法,统一 Agent 组织任务,可编辑画布承载方案。设计重点是让创作过程支持专业细化与多方向探索。
从已有脚本开始、更换创意或并行比较方案时,需要重走步骤、手动传递资料。
大纲、脚本和分镜呈现不足,难以逐步判断与精修;依赖最终视频试错,生成成本较高。
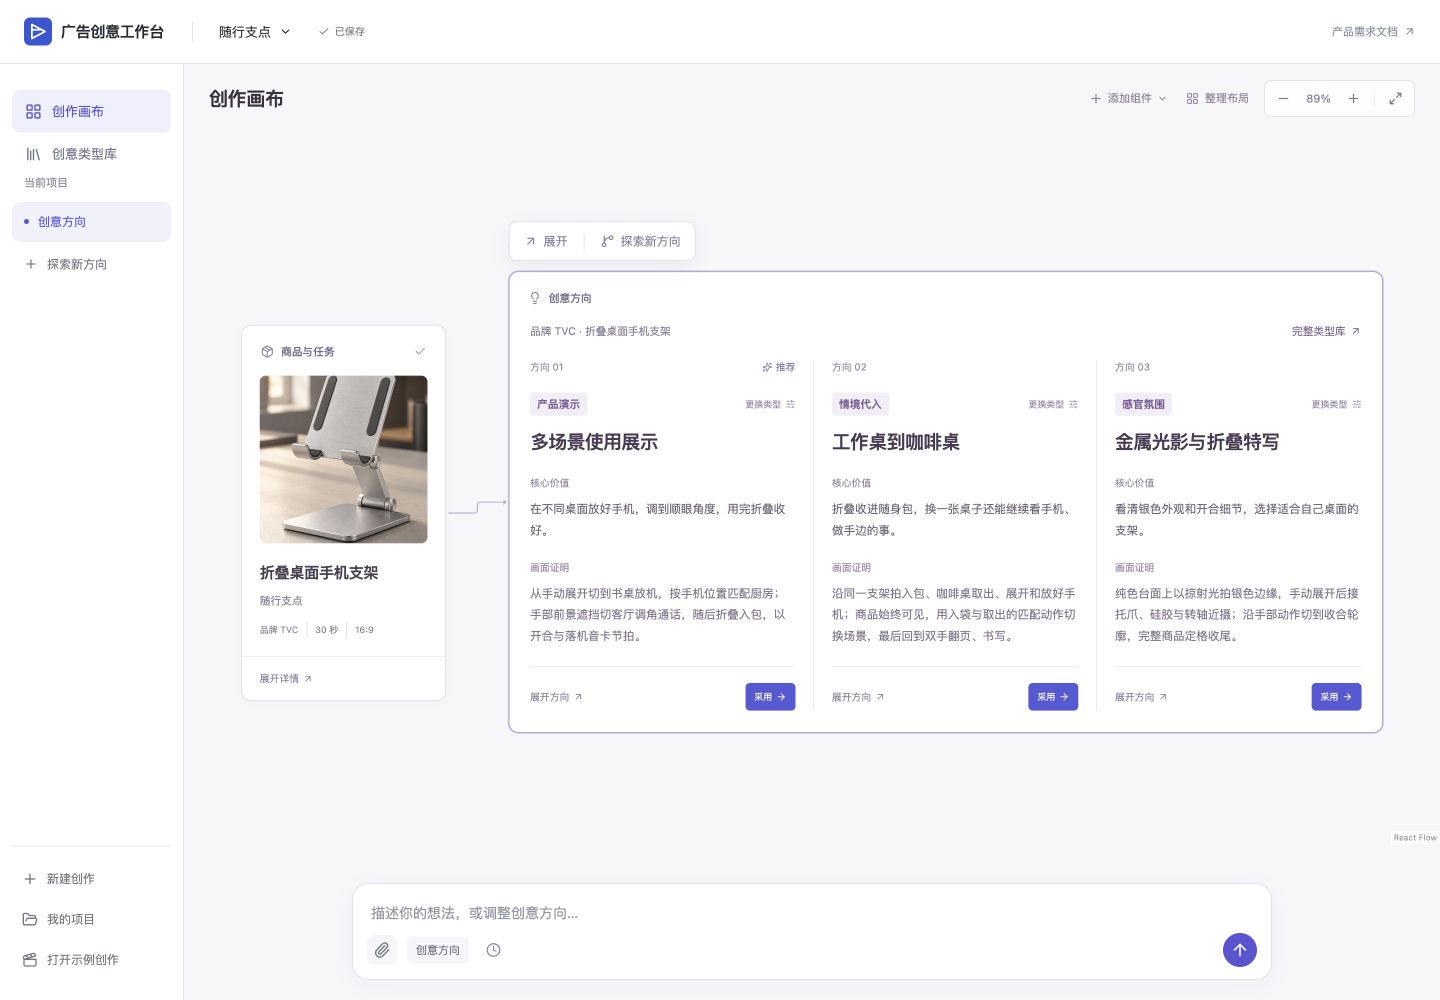
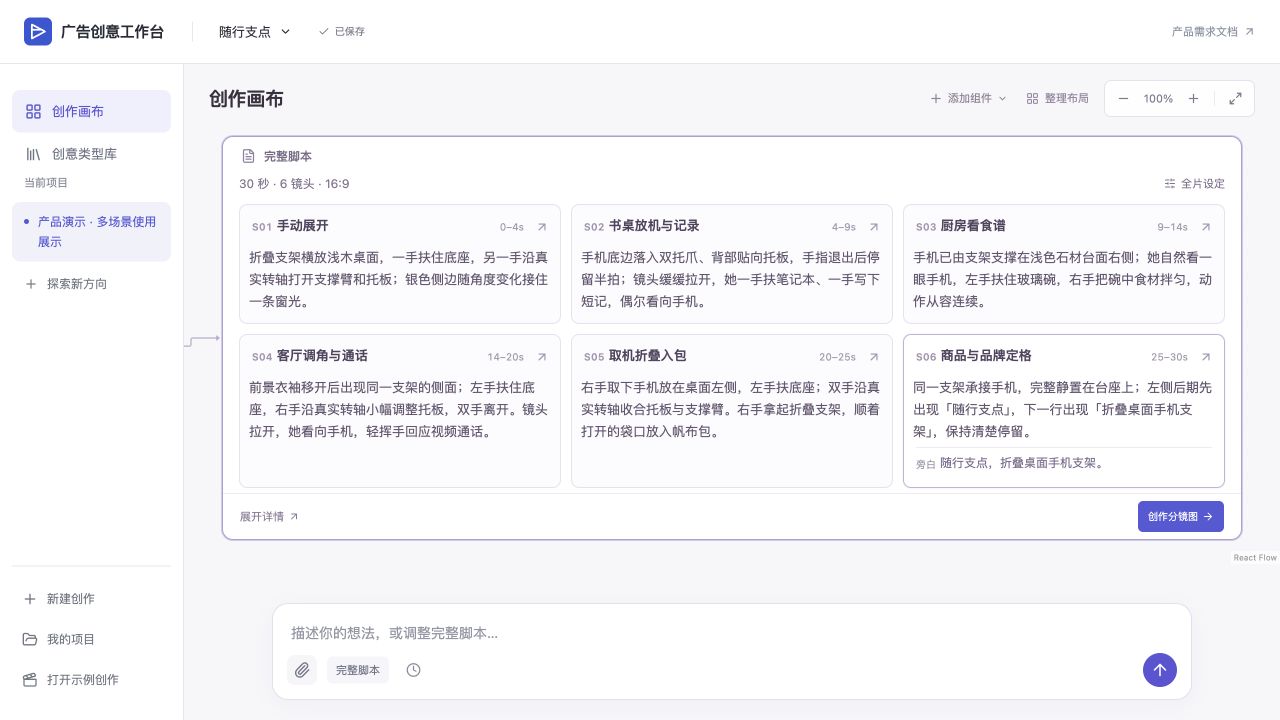
按广告类型与商品品类选创意,逐步落实为脚本、分镜与视频。
根据已有内容和当前要求安排任务,负责调用知识、传递资料与更新内容。
阶段成果直接预览和编辑;从共同资料建立分支,保留不同方案分别推进。
同一个 Agent 贯穿创作全过程,根据用户目标决定继续、调整或新建分支。它读取当前方案和资料,选择 Skill 并调用工具,将结果写回对应组件。
从案例中提炼品类与表现方法,用 Skill 规定创意、脚本和生成任务的步骤与要求。
按指令完成检索、资料读写、内容编辑,以及图片和视频生成。
记录每个方案使用的资料和生成结果,修改前序内容时找到受影响的后续组件。
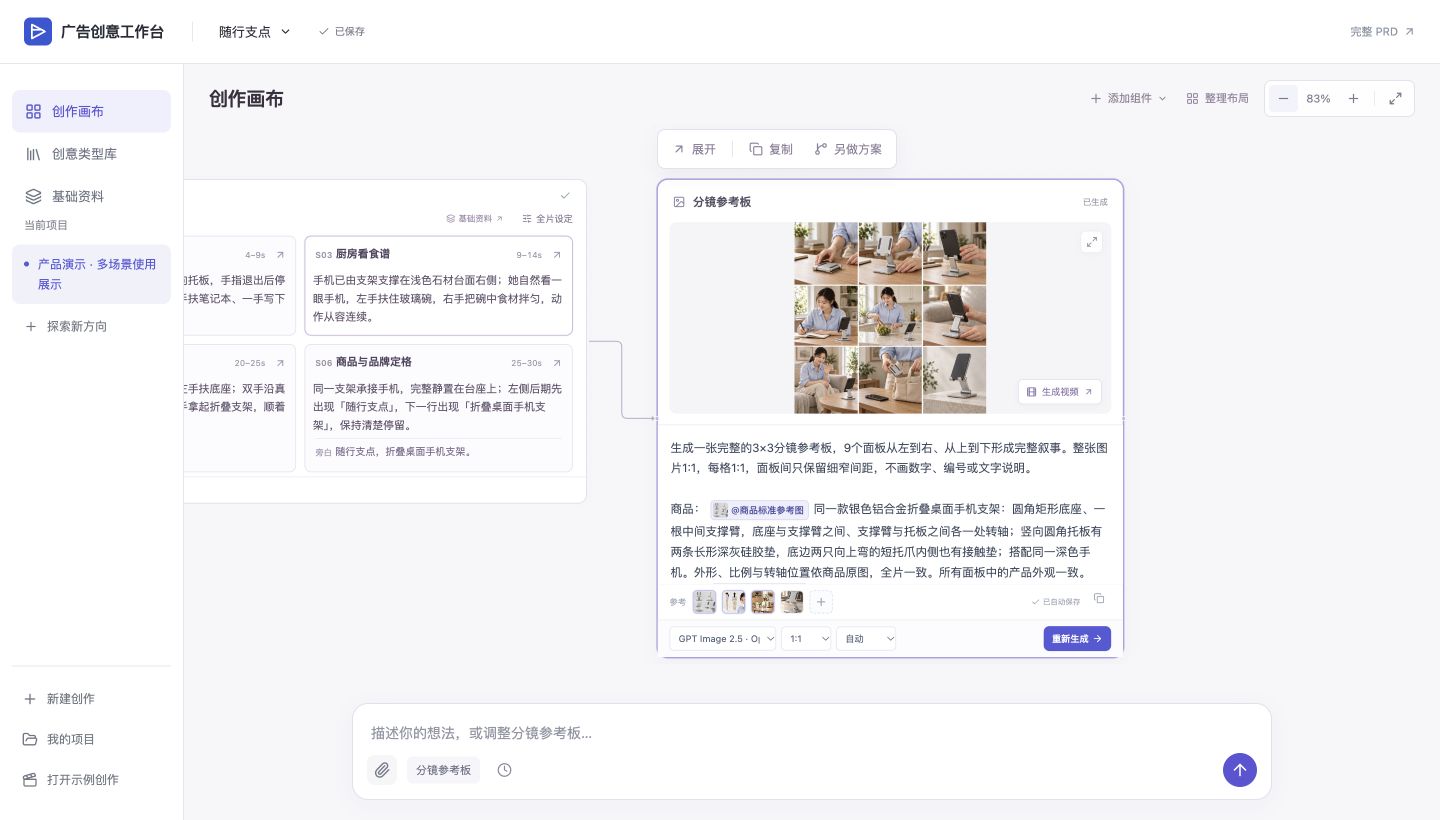
先检查静态画面,再投入动态制作。生图与视频组件都在上方呈现结果,下方保留完整提示词、素材引用与独立参数。

从全片选取九个静态瞬间,形成一张 3 × 3 参考板。直接修改完整提示词、引用和参数,检查商品、人物、构图与风格。

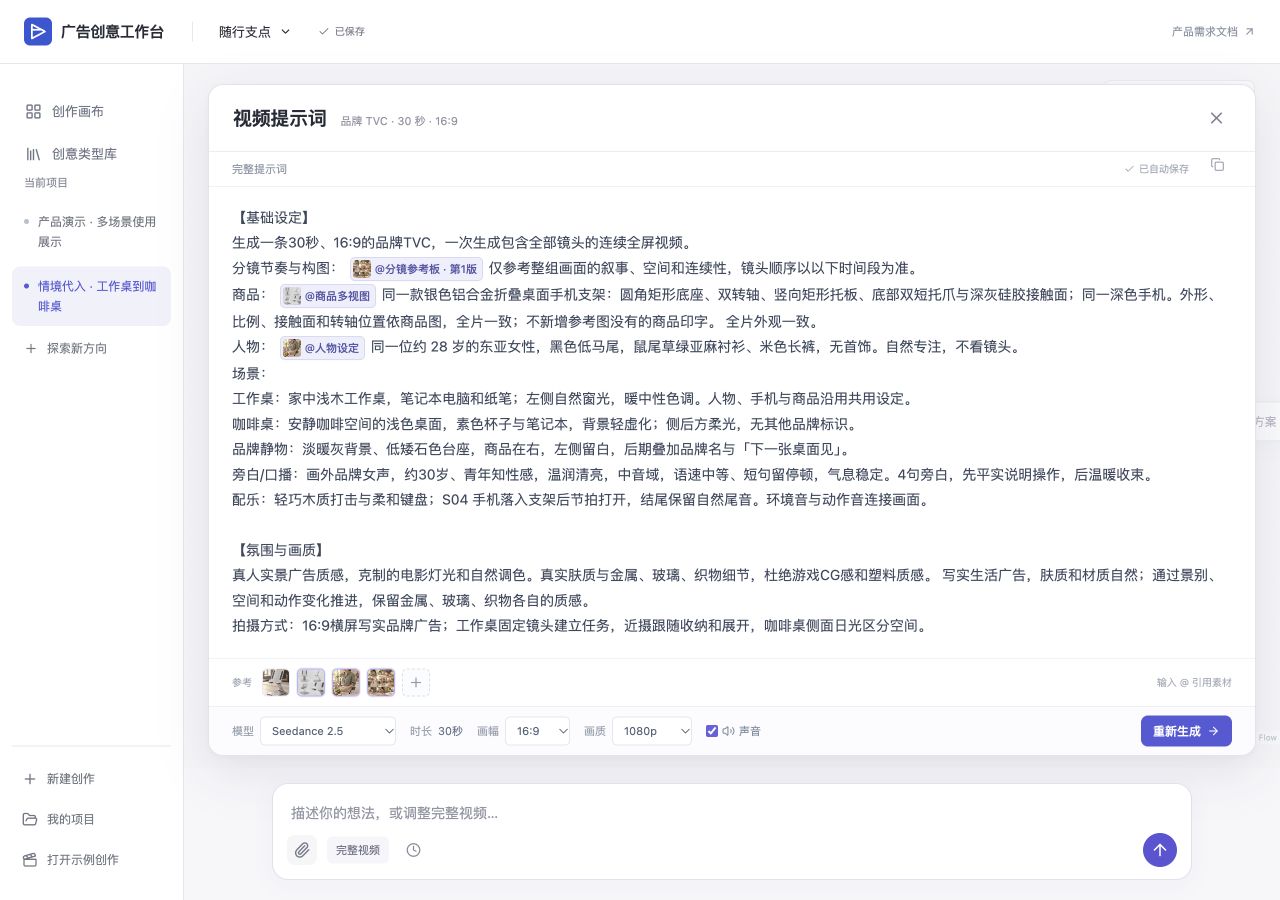
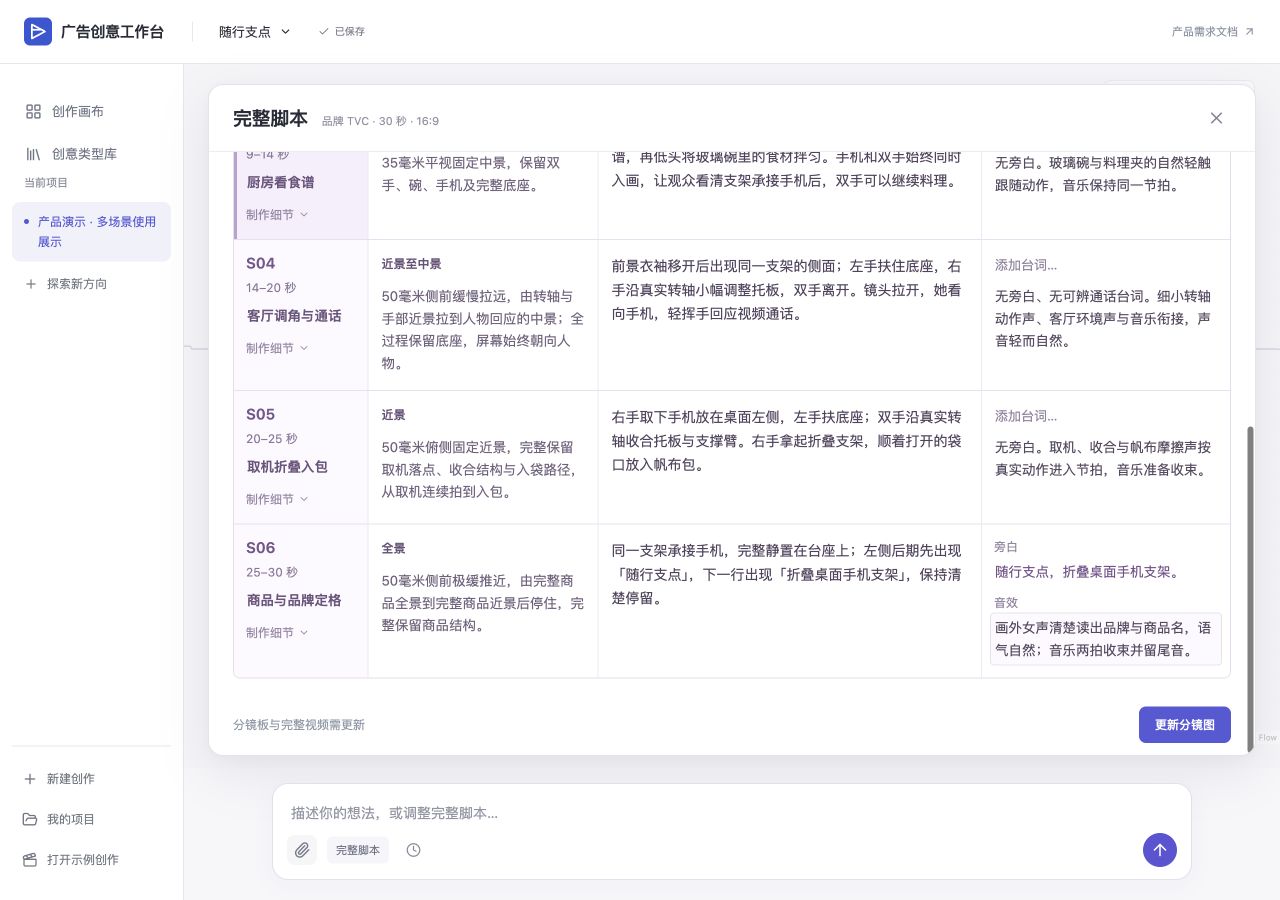
将所选分镜图、完整脚本与全片设定带入视频组件,精修提示词和片长等参数;一次提交整段多镜头任务,结果在原组件播放与采用。
编辑与生成分开:文本、引用和参数自动保存;生成、重试及采用由用户触发。视频保留所选图像版本,后续新图由用户决定是否改用。
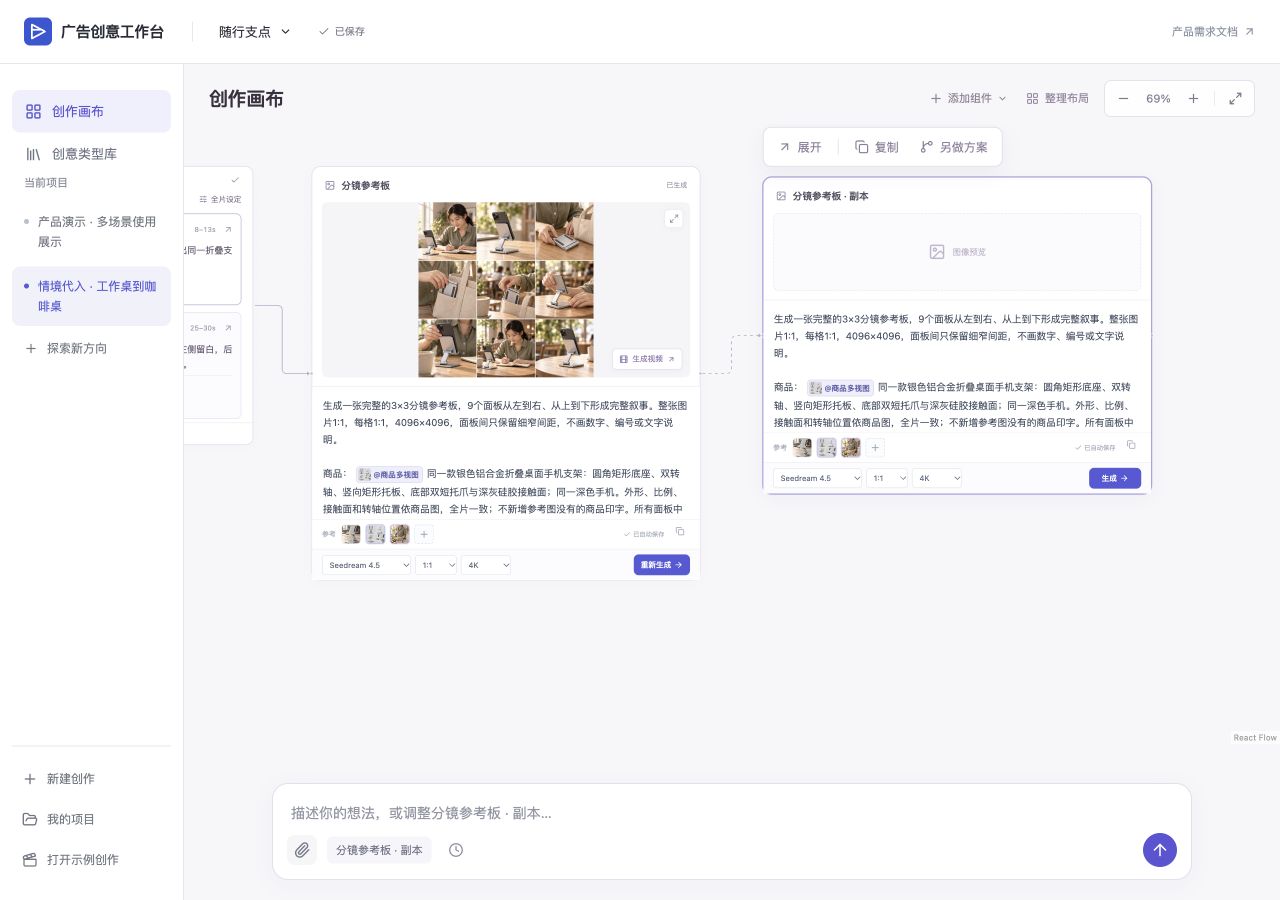
按修改范围提供三种操作:编辑内容、复制生成组件、建立创意分支。每种操作都保留原有结果,便于比较。
直接编辑或向 Agent 提出要求。修改脚本后,标出需要更新的分镜与视频,由用户决定何时重新生成。

复制提示词、参考素材和参数,调整后生成另一版画面或视频,与原版比较。

尝试其他创意时,从同一商品资料建立新分支,分别生成大纲、脚本和视频,保留原方案。

完成 32 例广告的创意与视频评测,据此优化创意知识、脚本及生成表现。中期数据表明,投流创意质量是主要短板;视频侧重点改善真实感与商品细节。
需求理解、参考理解、策略选择、脚本完成度
脚本还原、一致性、动作、异常元素与真实感
各维按 0 / 1 / 2 分评价;创意四维、视频六维。先计算每例适用维度均分,再按案例平均;不适用项不计入。
优化后已有样例对照记录,完整类别均分待同口径复评。
固定商品任务、样本构成与生成预算。
同时记录首次达标所需生成次数、一次达标率、人工操作时长与用户等待时长。进入试用后,再结合首次成果采纳率、修改轮次与阶段转化率,判断质量改善是否降低实际创作成本。
原型成果:完成工作流、Agent 职责与画布交互设计,贯通资料输入、方案分支、分镜预览及视频生成操作。Demo:ad-creative-workbench.pages.dev
为硕士课题开发三个独立工具,分别支持训练数据集构建、模型输出核对与专家对照评价。

硕士课题使用多模态大模型评估街道可步行性。实验中需要反复配置数据处理任务、核对图文结果,并汇总多位专家的独立评价。
将数据集构建、模型输出核对和专家评价做成界面,减少重复配置与人工匹配,支持按相同样本和评价维度比较结果。
设计并开发三个配套工具。数据构建与结果检视服务课题内部工作,专家评价系统供参与测评的规划专业人员使用。
以 Qwen3-VL-32B 为基底模型,将可步行性知识图谱内容注入上下文,并用 LoRA 微调学习如何依据街景解释步行体验及其成因。
批量街景图像作为评估对象。
领域知识与模型微调共同支持空间诊断及问题归因。
通过 RAG 检索领域知识,匹配规划策略。
融合诊断与对策,输出含推理路径与可视化结果的评估报告。
研究人员使用前两个工具准备数据、核对模型结果,规划专业人员使用评价系统独立评分。各工具统一样本编号与结果字段,便于研究人员汇总比较。
| 环节需求 | 产品决策 | 验证重点 |
|---|---|---|
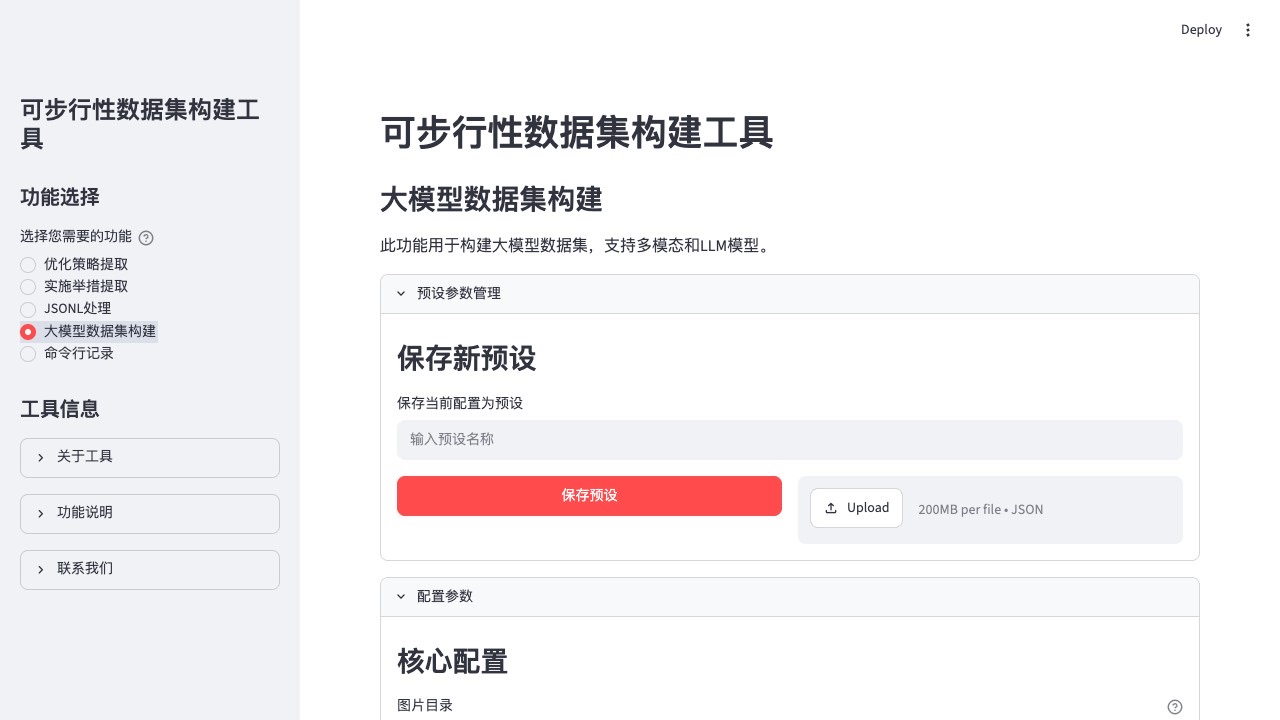
| 重复配置数据处理任务 | 将图片目录、提示词及格式转换做成可保存的参数预设。 | 数据字段完整,可复用同一配置 |
| 图像与模型记录难核对 | 按图片名自动关联;画册筛查、单条详读、表格比对。 | 样本对应准确,异常结果可定位 |
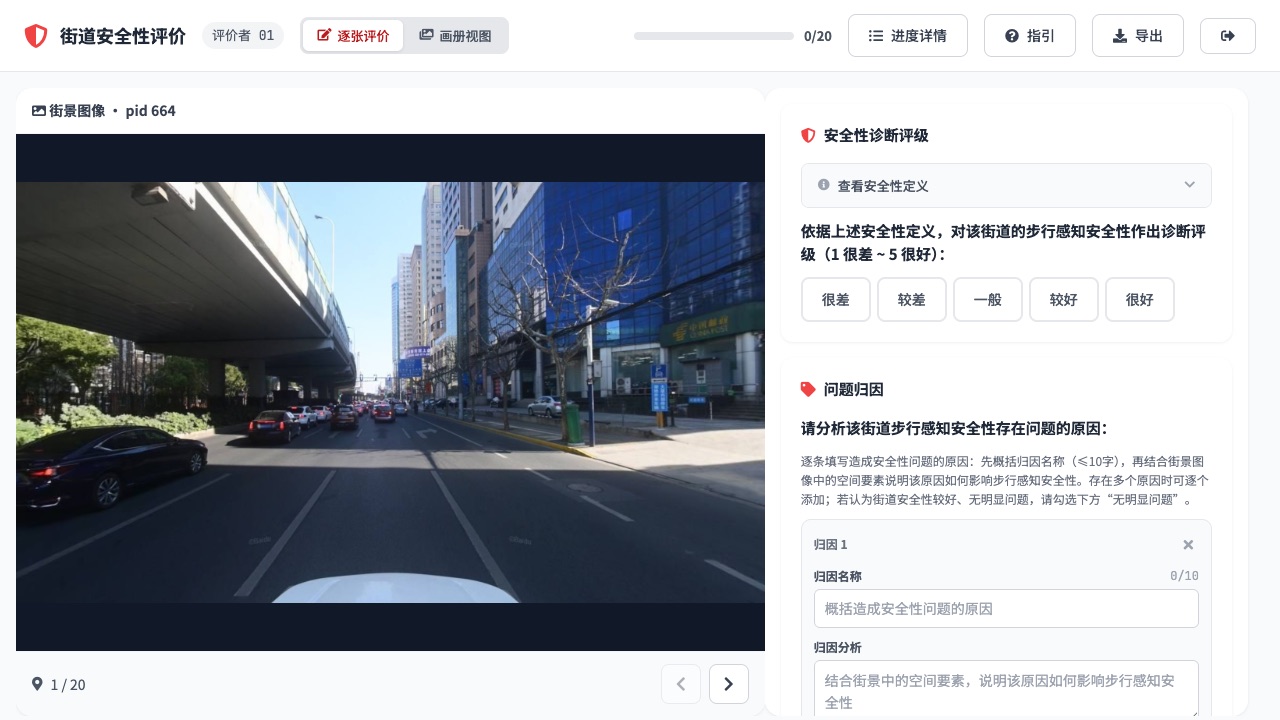
| 分散收集专家评价 | 网页提供统一量表,按评价者保存,导出相同字段。 | 评分可汇总,与模型逐样本比较 |
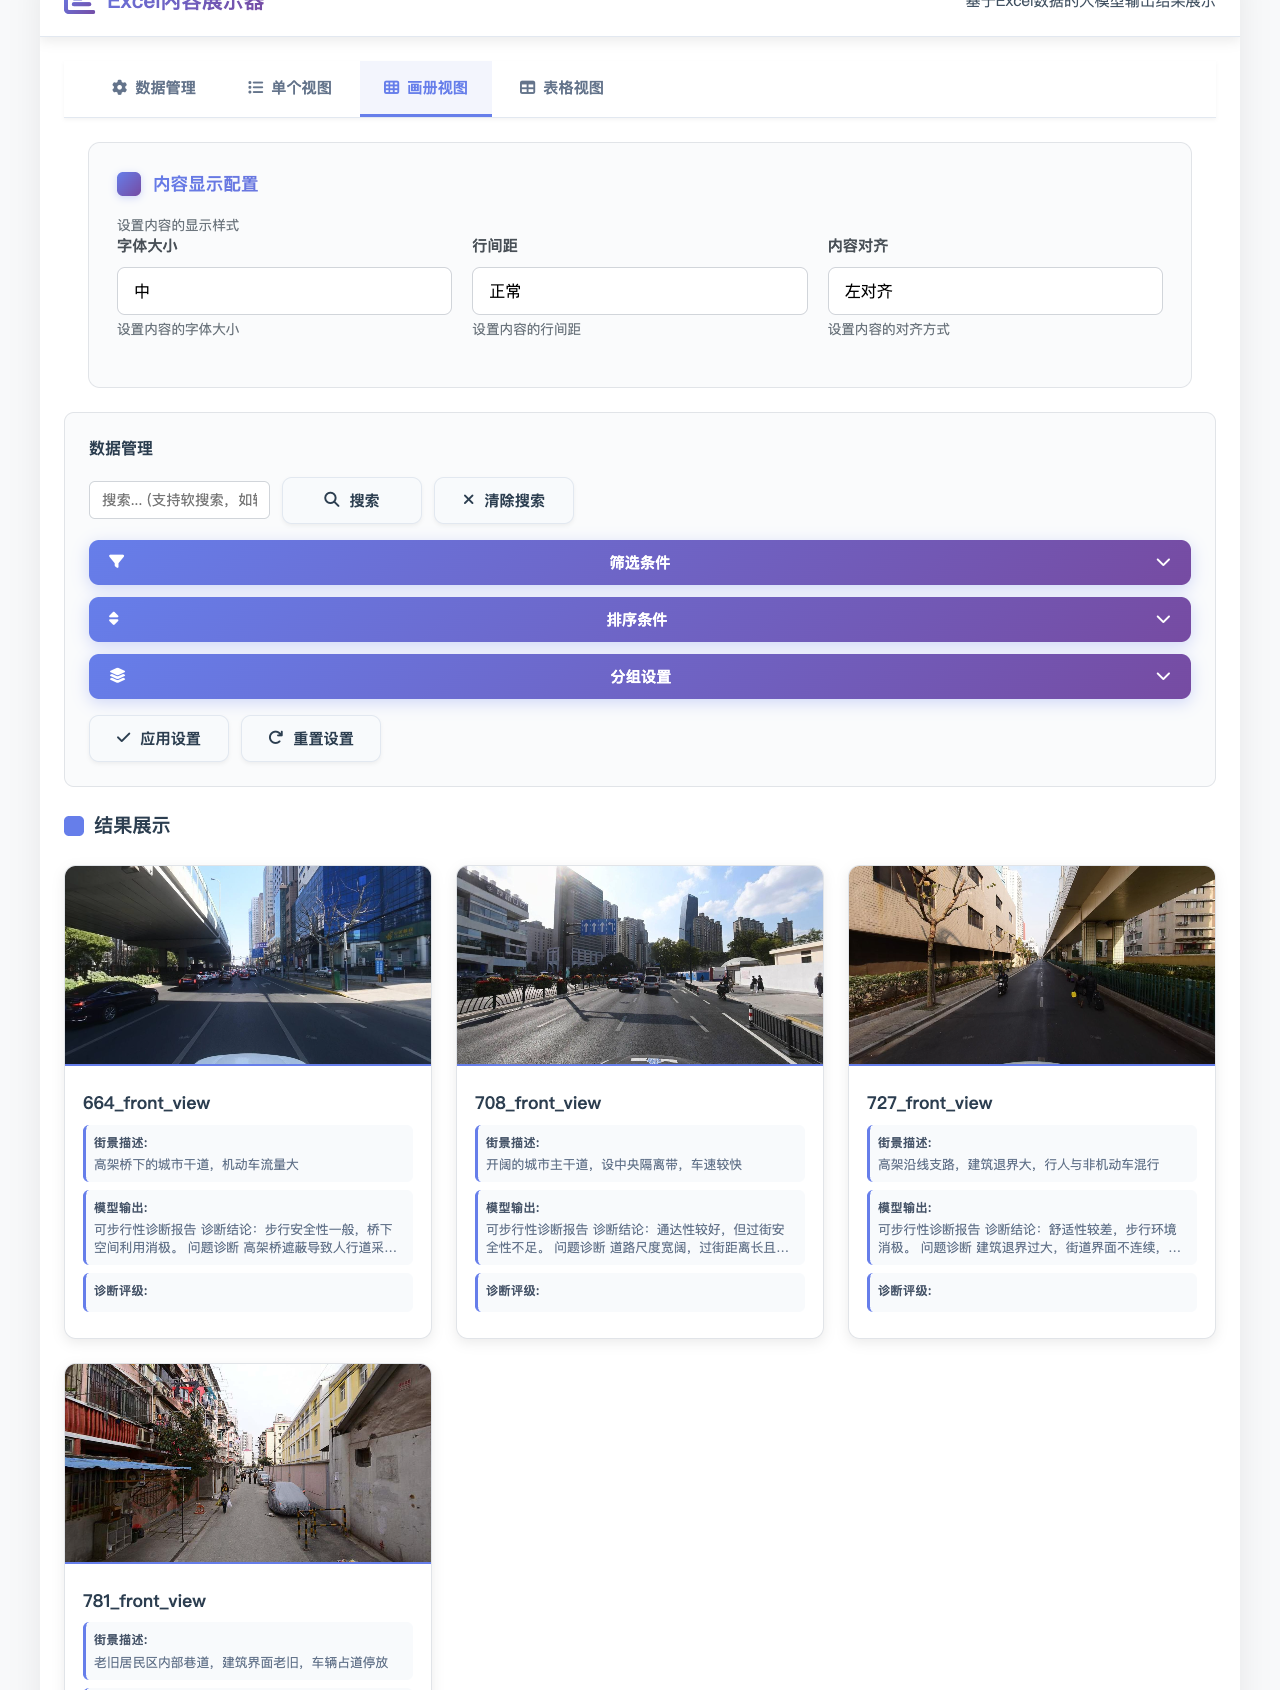
数据集构建工具集中配置任务参数;模型输出检视工具将图片与记录关联,支持从批量浏览切换到单条检查。
将数据处理参数集中配置并保存为预设,重复实验时直接复用。
图像与模型记录关联展示,通过搜索、筛选和分组定位需要核对的样本。
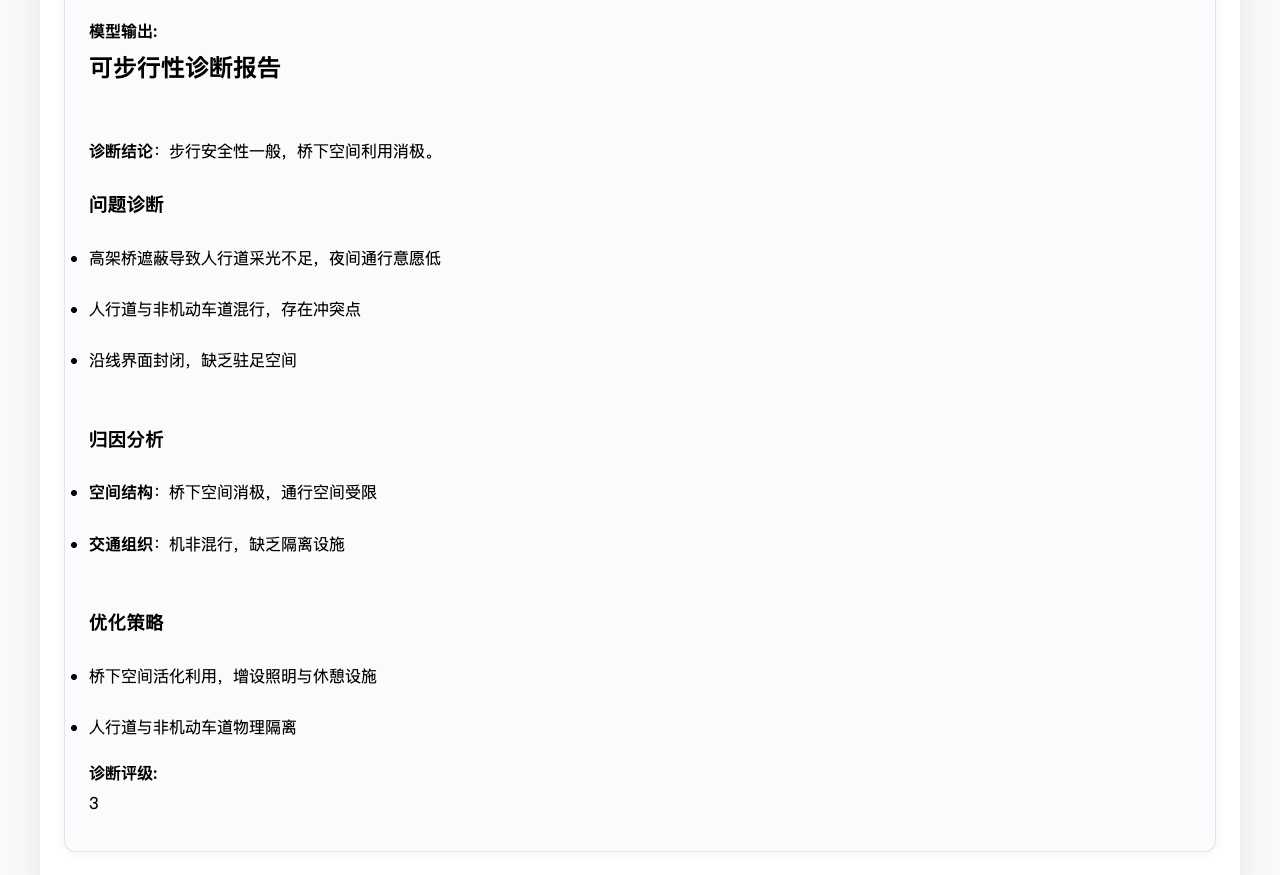
模型报告直接渲染,图文同屏核对,检查诊断结论与图像依据。
评价系统按通达性、安全性、舒适性、愉悦性四个层级设置细分评价项,每项采用五级量表,并支持填写问题原因与优化策略。评价字段与模型输出保持一致。
13 名规划专业人员参与评价。使用统一网页独立打分,导出结果后按样本与维度汇总,与模型输出进行对照。

| 指标 | 优化前 → 优化后 | 结果含义 |
|---|---|---|
| 专家评分范围覆盖率 | 23% → 80% | 落在专家均值 ±1 标准差内的样本比例 |
| 评分平均绝对误差 | 1.80 → 0.49 | 模型评分与专家均值的偏差缩小 |
同组 100 张图像、13 名专家;安全感知任务,指标以原始评分计算。
面向个人求职,把岗位筛选、探查、准备、日程、录音与复盘组织在同一个工作区,并延伸到 Chrome 辅助填报。
本章展示当前迭代界面,截图使用合成演示资料。
求职需要筛选岗位、研究公司、准备面试并总结问题。信息散落在表格、文档和录音中,进度变化后,相关材料容易脱节。
按公司、岗位和面试场次集中关联资料,减少查找与重复整理;通用经历、公司准备和每场复盘分别维护,支持 Agent 辅助整理与修改。
定义需求与资料结构,设计任务流程和交互,借助 AI 编程实现桌面 App 与 Chrome 扩展,在个人求职中持续使用和迭代。
按公司与岗位关联投递、探查和准备材料,按面试场次关联日程、录音与复盘。用户可直接进入当前任务,复盘后继续修改准备内容。
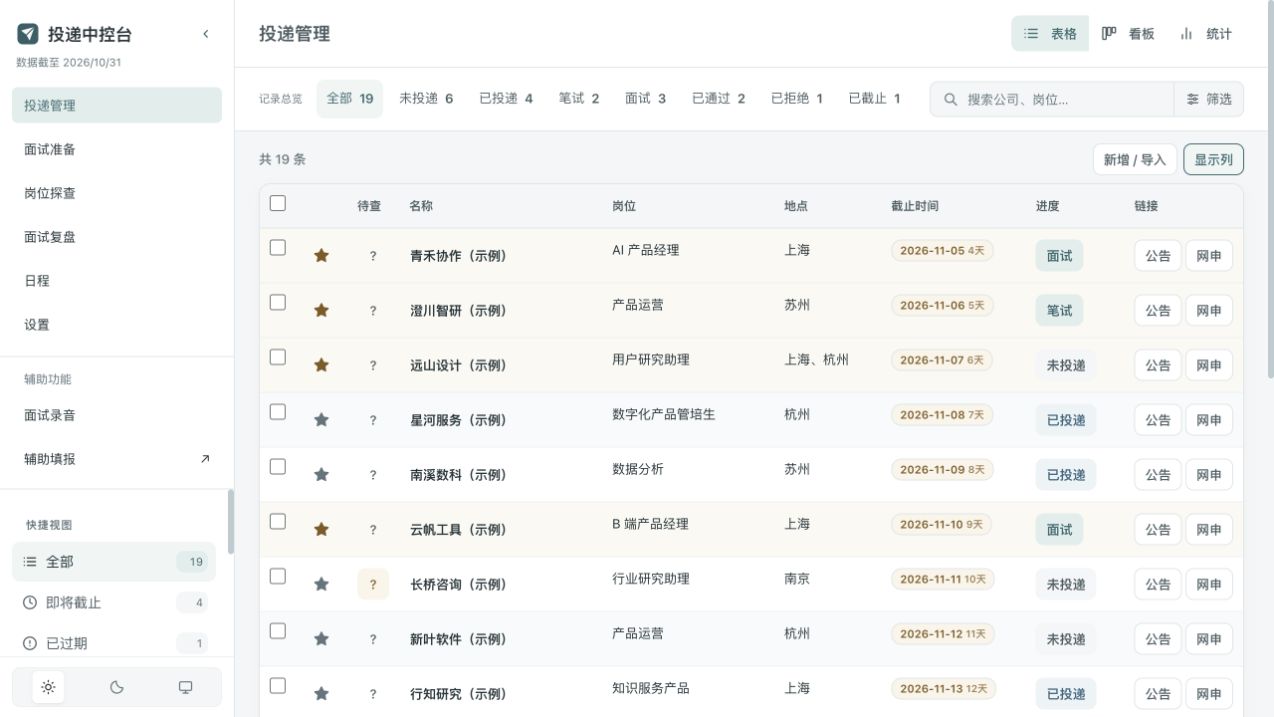
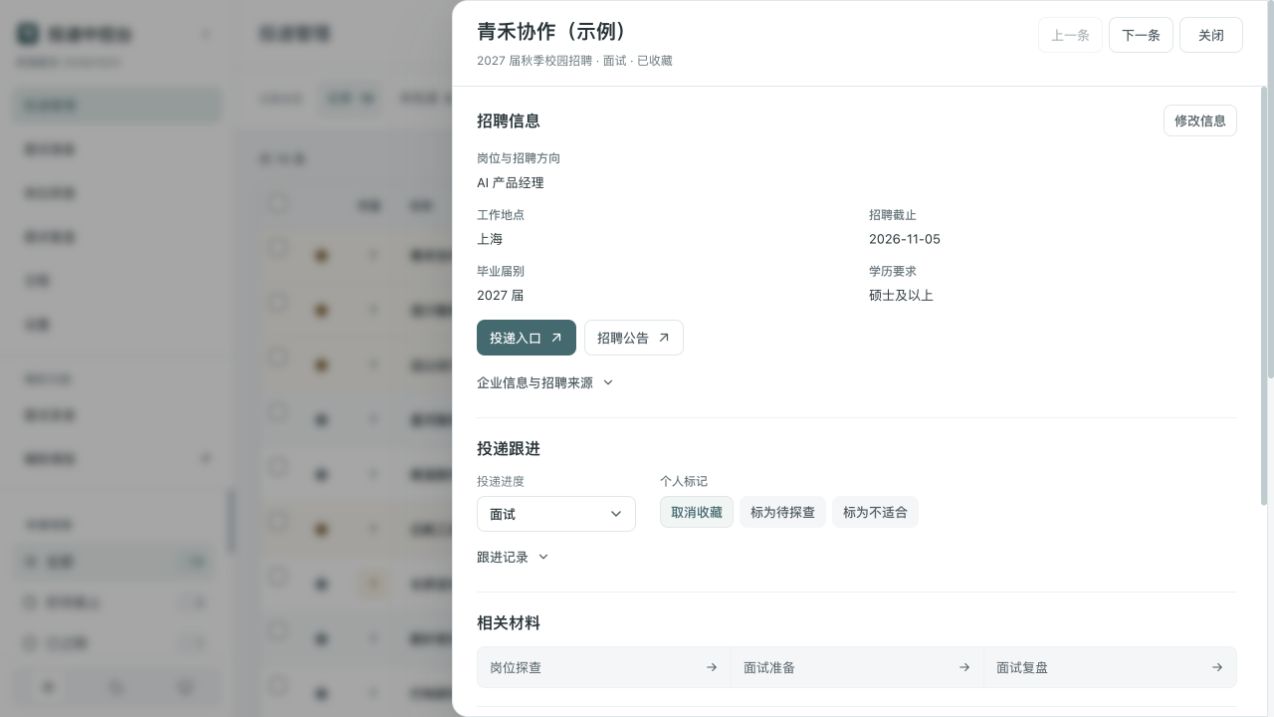
表格、看板与统计共用同一筛选结果。进入岗位详情后,可以结合完整岗位信息、个人标记和探查证据作判断,并继续查看相关材料。
按岗位、城市和招聘条件搜索筛选,结合进度、收藏与适合标记,管理当前值得跟进的机会。
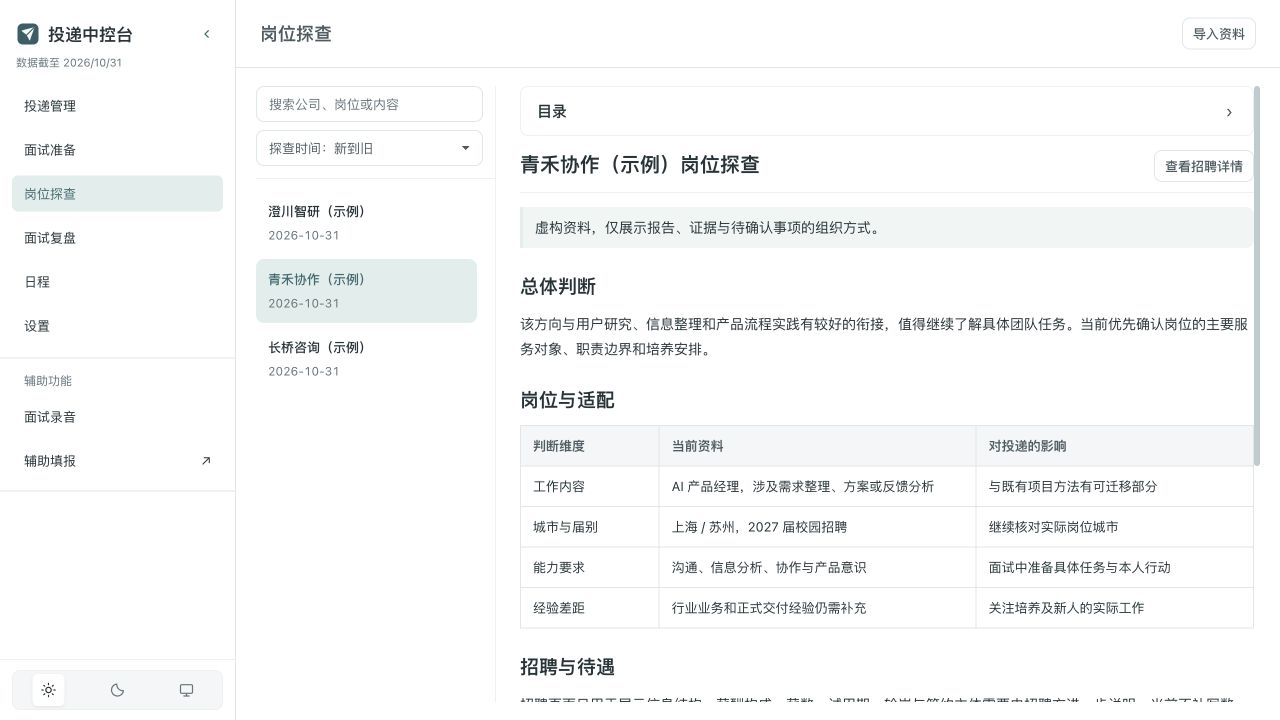
按公司保存岗位要求、招聘与待遇等探查内容,区分事实、判断与待核实项,保留来源和附件。
从详情进入探查、准备、复盘与日程;招聘信息更新时,进度、收藏和备注单独维护,保留个人判断。
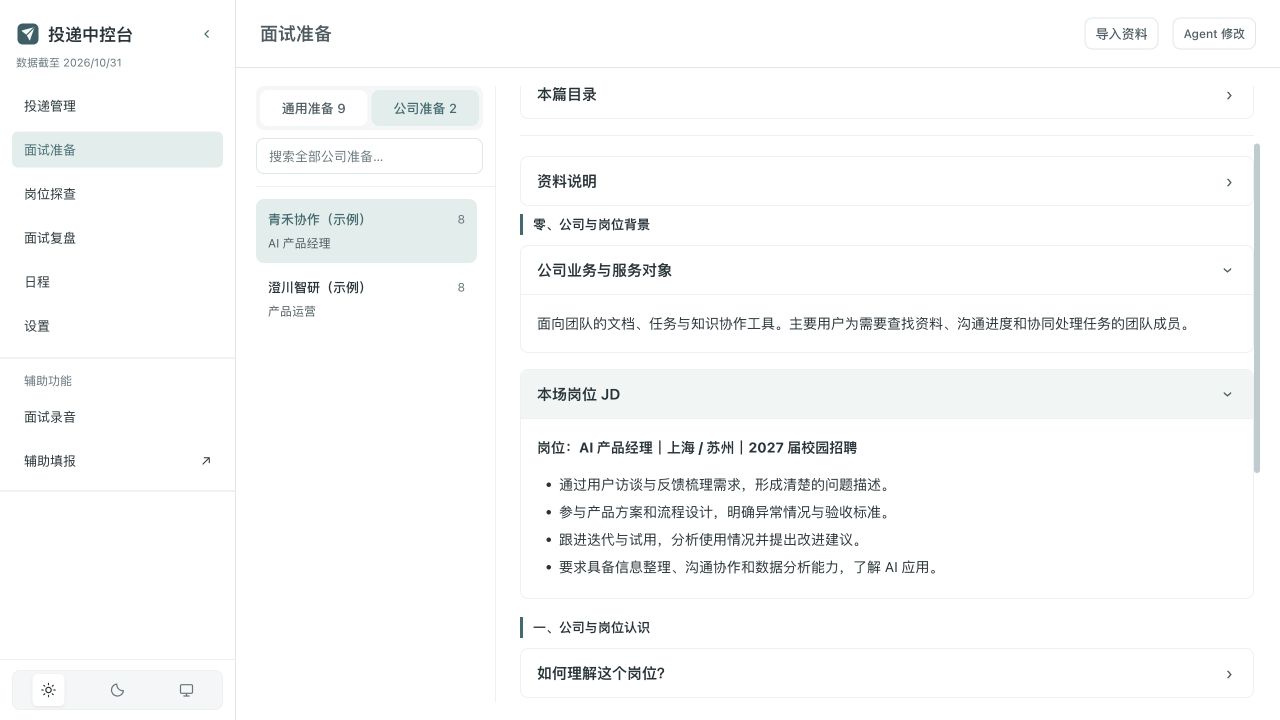
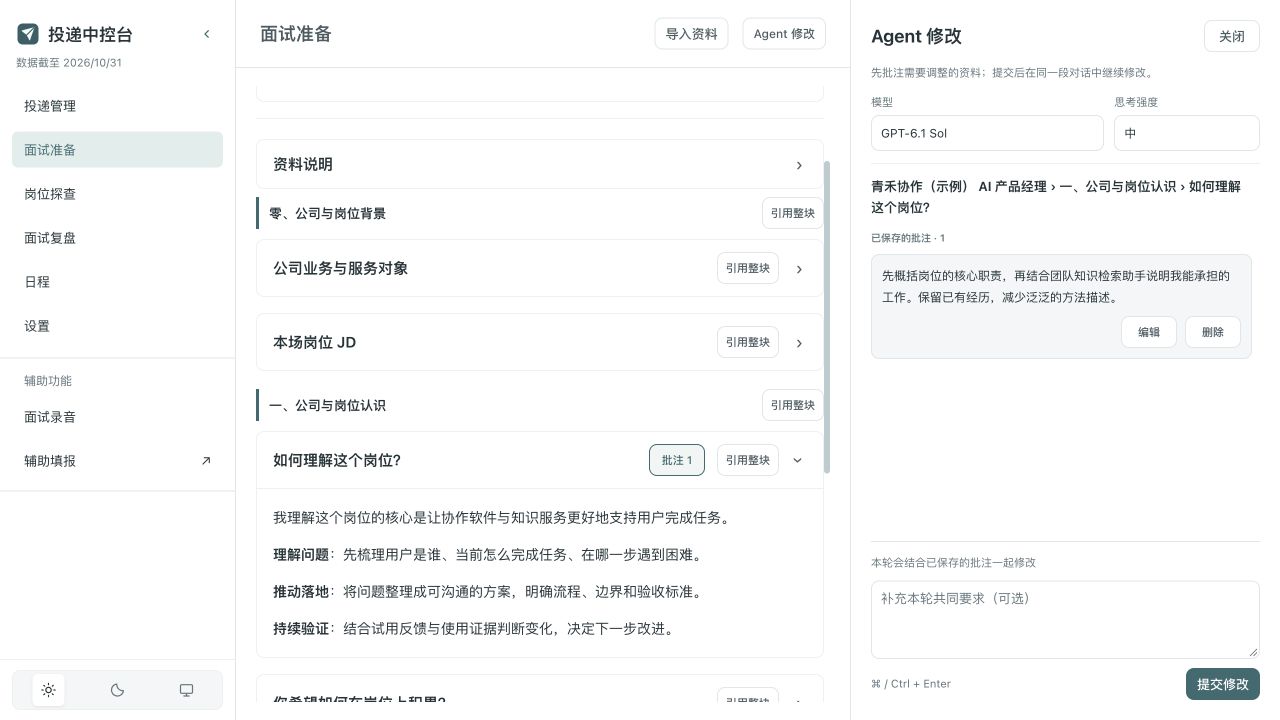
个人经历统一维护,公司材料按岗位要求编写。阅读时可选中原文向 Agent 提出修改要求,直接查看和调整修改结果。
项目经历、行为题和基础知识集中维护,保留主答与备答;检索后直接定位具体内容。
公司准备前置业务背景与实际 JD,再组织岗位认识、自我介绍、场景判断和反问。
选中段落或整篇内容提出要求,查看 AI 修改后的全文,再决定采用或继续调整。
每场面试关联日程、录音、逐字稿和复盘。面试前查看安排与准备材料,面试后对照实际回答分析问题,修改后续准备。
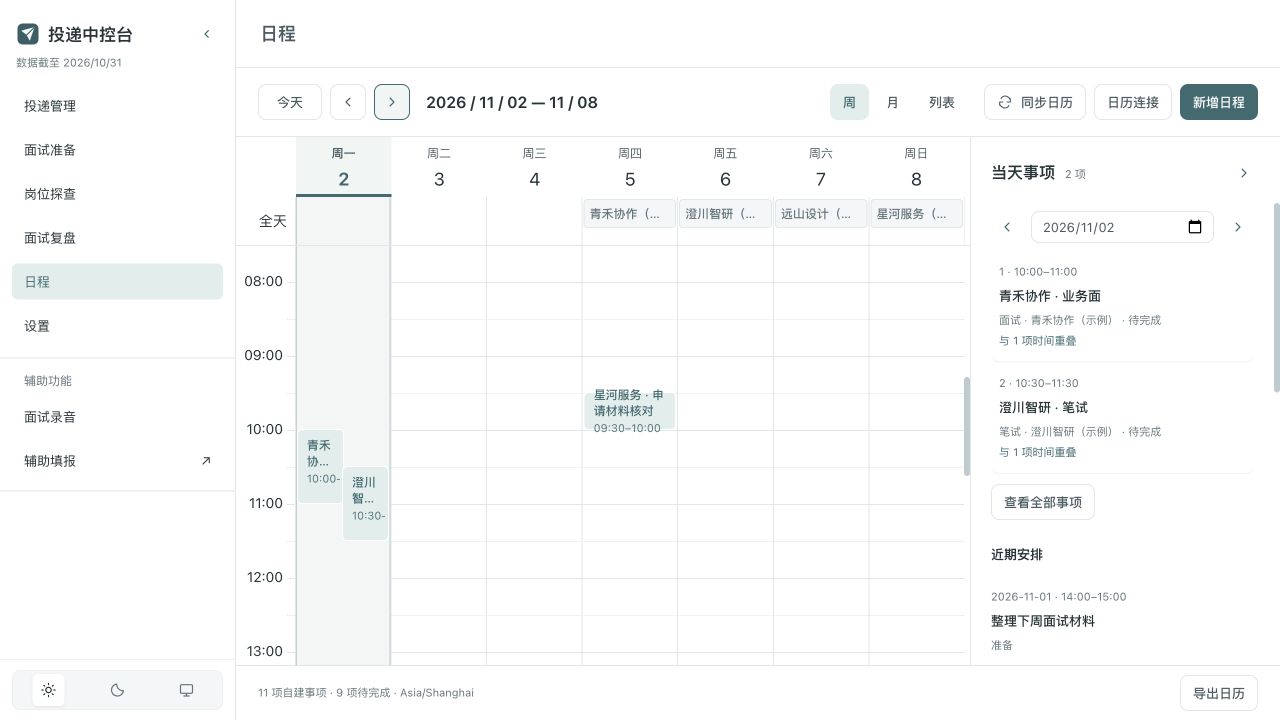
周、月和列表视图集中查看面试、笔试与截止日期。事项关联公司、会议信息和准备材料,支持改期与时间重叠提示。

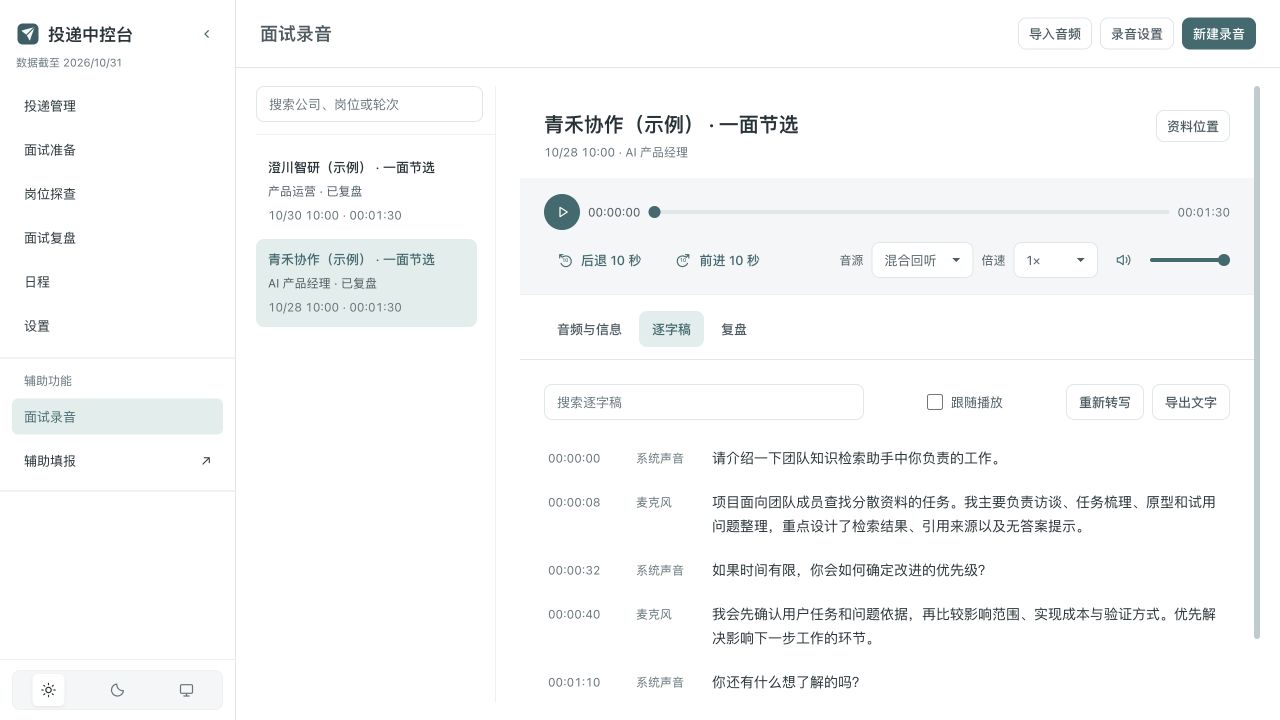
双轨录音分别保留麦克风与系统声音,支持混合回听。逐字稿按时间定位,关联同一场次,为复盘保留原始回答。

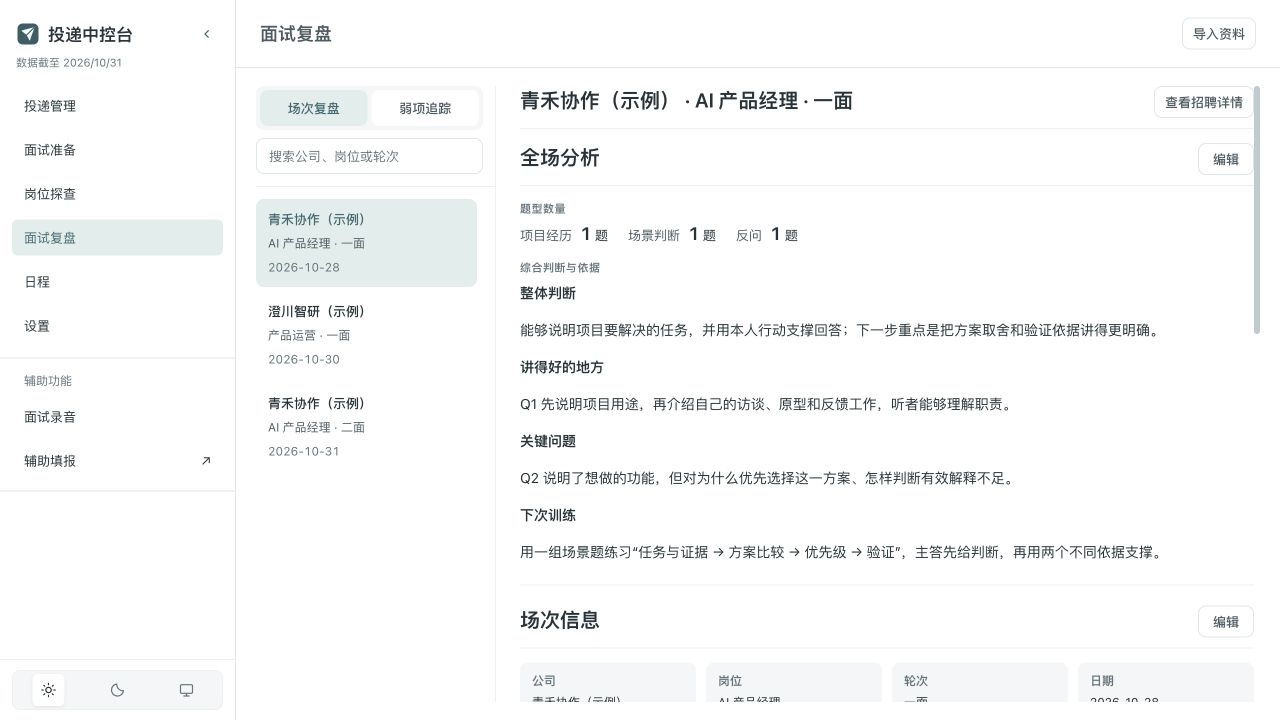
全场分析先归纳重点,再保留逐题原答、追问与诊断。跨场次跟踪反复出现的问题,回到准备材料进行针对性修改。

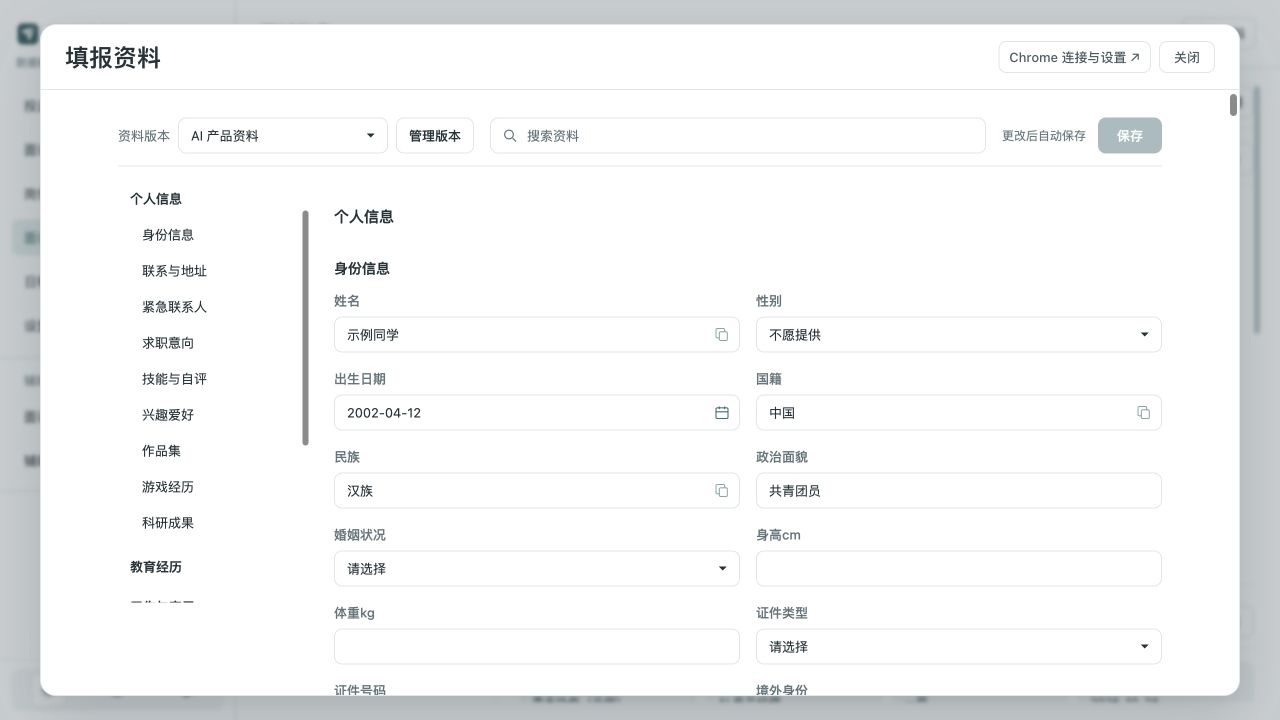
不同求职方向可使用独立的完整资料版本,各版本分别编辑、自动保存。App、Agent 与已连接的 Chrome 扩展共用同一工作区资料,减少重复维护。
按整段经历维护原文,复制版本后可独立修改。
在当前招聘网页识别表单,使用本次适用资料;可选择仅填空白,保留网页已有值。
根据所选资料匹配网页字段,填写后展示结果,供用户检查。
未匹配的字段可从“我的资料”搜索复制,补充附件并检查后提交申请。
| 验证方向 | 已有结果与范围 |
|---|---|
| 个人日常使用 | 个人工作区管理 6,196 条招聘记录、117 份探查报告,规模截至 2026 年 10 月。 |
| 产品交付 | 已形成桌面 App、Chrome 扩展与开源代码;投递、材料与面试任务可在同一工作区持续管理。 |
| 后续评价 | 按任务记录资料查找与任务完成时长、内容修改次数,以及网页填写后的字段正确率。 |